
我第一次看到 OpenFilm 的 README,最先注意到的不是功能,而是它對 Remotion 和 HyperFrames 的那句挑釁:「No framework… one function is enough.」做影片不需要框架,一個函式就夠了?我半信半疑把整個 repo clone 下來,把手冊、10 個內建 skill、兩個官方範例和所有 GitHub issue 從頭讀到尾。結論是:這東西的設計真的漂亮,但它還很新,有幾個坑你最好在動手前就知道。
這篇是我整理出來的 OpenFilm 新手教學:從安裝、原理、六個指令,到依 10 種影片類型分好的 prompt 範本,最後再加一個我自己很喜歡的玩法——用 NovelAI(NAI Studio)生繪本插圖,丟給 OpenFilm 做成會動的繪本影片。
本文環境與版本
- OpenFilm v0.2.4(2026-10-20 發布),MIT 授權
- 需求:Node 22.2+(從原始碼開發需 22.18+)、ffmpeg、git;首次執行會下載約 100 MB 的 headless Chromium
- Agent:Claude Code、Codex、Cursor、Gemini CLI 等任何能跑指令的 coding agent
- 前置知識:會開終端機、會跟 AI agent 對話就夠了,不需要會寫前端
OpenFilm 是什麼?不是影片生成模型
先把最常見的誤會講清楚:OpenFilm 不是 Sora、Veo 那種「打一句話吐出一段寫實影片」的模型。它是一套讓 coding agent「用網頁拍片」的格式、工具和剪輯器。
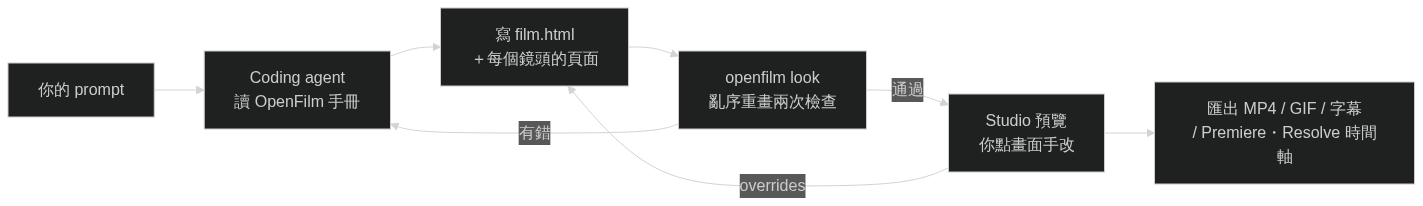
官方 README 用三句話介紹自己:一個 HTML 檔、一個函式、一個真正的剪輯器。你叫 Claude Code 做一支片,它會寫出一堆網頁,每個網頁是一個鏡頭;OpenFilm 負責把它們排上時間軸、檢查、渲染成 MP4,再給你一個叫 Studio 的本機剪輯器,讓你直接點畫面上的字改掉,不用再 prompt 一輪。
這個專案 2026 年 10 月 4 日才建立,到我寫這篇的 10 月 22 日已經衝到約 1,800 顆星,10 月 10 日到 20 日之間就發了 10 個版本(v0.1.3~v0.2.4)。explainx 的介紹文 記錄 10 月 20 日時約 1.3k 星,兩天又多了快 500,成長速度有點誇張。
所以它擅長的是任何瀏覽器畫得出來的東西:字卡、動態圖像(MG)、圖表、產品示範、歌詞 MV、白板講解、照片回憶片。寫實人物走路那種鏡頭它自己生不出來,要從別的工具生好再當素材匯入。
安裝:三種方式選一個
方式一:裝成 agent skill(最推薦)
npx skills add openfilm/openfilm
裝完直接對你的 agent 說話就好。官方 README 給的第一個範例 prompt 是:
Make a 20-second launch video for my CLI, with music.
agent 會自己去讀 OpenFilm 的手冊、開 Studio,你在瀏覽器裡看著片子一個鏡頭一個鏡頭長出來。
方式二:agent 沒有 skill 機制
有些 agent 不支援 skills,那就直接告訴它:
Run `npx -y openfilm@latest` and follow the manual it prints.
這招的原理很聰明:openfilm 不帶參數執行時,會印出一份約一千字的手冊(就是 repo 裡的 MANUAL.md ),agent 讀完就知道怎麼拍片了。整個 skill 檔本身只有一句話:「去跑這個指令,照手冊做」。
方式三:桌面版
到 openfilm.dev 或 GitHub Releases 下載 Mac(Apple silicon)或 Windows(x64)版。桌面版就是 Studio 旁邊多一個聊天視窗,可以接 Claude Code、Codex,也能填自己的 API key 用內建 agent。好處是內建 ffmpeg 和瀏覽器,什麼都不用另外裝,對不想碰終端機的人最友善。
完全免費嗎?
OpenFilm 本身免費、不用註冊,製作、編輯、渲染都在本機。要花錢的是兩件事:你的 agent 的 token,以及你在 Studio 的 Settings → Providers 接上的配音、音樂、圖片、影片服務(ElevenLabs、OpenAI、Google、fal 等),各自用你自己的 key 計費。
原理:film.html 加上 frame(t),就是全部

我讀 SPEC 讀到這裡的時候真的有點驚豔,因為整個系統的契約簡單到不行。
一部片=一個資料夾+一個 film.html
<meta name="viewport" content="width=1920, height=1080">
<style>
  .card { object-fit: cover; border-radius: 24px; }
</style>
<section>
  <iframe src="title.html#t=0,4"></iframe>
</section>
<section>
  <video src="assets/footage.mp4#t=12,18" at="4" speed="0.5" class="card"
         style="left: 160px; top: 90px; width: 1600px; height: 700px"></video>
</section>
<section>
  <audio src="assets/music.mp3" volume="0.6"></audio>
</section>
對照剪輯軟體的概念:
| film.html 寫法 | 剪輯軟體裡的意思 |
|---|---|
<section> | 一條軌道,寫在越前面的疊在越上層 |
<iframe> / <video> / <img> / <audio> | 一個片段(頁面、影片、圖片、聲音) |
#t=12,18 | 取素材的第 12~18 秒 |
at="4" | 放在片子的第 4 秒開始 |
style 的 left/top/width/height | 畫面上的位置與大小 |
speed / volume | 變速(0.25~4)/音量 |
overrides | 你在 Studio 手改的內容,agent 之後修改會保留 |
每個鏡頭=一個實作 frame(t) 的網頁
<script type="module">
window.film = {
  frame(t) { /* 畫出第 t 秒的完整畫面 */ },
  duration: 4,             // 選填:這頁自己多長
  ready: loadFonts(),      // 選填:字型、圖片載好再開始畫
  width: 480, height: 320, // 選填:只佔畫面一角的小頁面
};
</script>
唯一的規則,官方用粗體寫著:同一個 t 永遠要畫出同一張畫面,不管之前畫過什麼。因為渲染時會亂序、平行、甚至在兩格之間取樣(做動態模糊),只要守住這條規則,任何電腦、任何解析度輸出的結果都一樣。
整個流程大概長這樣:
Before/After:新手 agent 最常犯的錯
這條規則對人類前端工程師很反直覺,因為我們習慣用 requestAnimationFrame 讓東西自己動。下面這種寫法在瀏覽器裡看起來正常,渲染出來卻會亂跳:
// 錯誤:畫面取決於「之前執行過幾次」和亂數,不是取決於 t
let x = 0;
window.film = {
  frame(t) {
    x += 5;                                   // 狀態累積
    dot.style.left = x + 'px';
    dot.style.opacity = Math.random();        // 每次都不一樣
  },
};
正確寫法是讓一切都只從 t 算出來,需要隨機感就用以 t 為種子的偽隨機:
// 正確:純函式,同一個 t 永遠同一張圖
const rand = (n) => { const s = Math.sin(n * 12.9898) * 43758.5453; return s - Math.floor(s); };
window.film = {
  duration: 4,
  frame(t) {
    dot.style.left = (t / 4) * 1600 + 'px';             // 位置由 t 決定
    dot.style.opacity = 0.5 + 0.5 * rand(Math.floor(t * 10)); // 閃爍也由 t 決定
  },
};
好消息是你不用自己抓這種 bug。OpenFilm 的 look 指令會把聯絡表的每一格用兩種打亂的順序各畫一次,哪格不一樣就點名,順便抓頁面錯誤、字型沒載到、音檔不見、文字被裁切。官方說得很直白:它把力氣花在「模型會失敗的地方:檢查影片」。
六個指令,看懂就能跟 agent 對話
這些指令通常是 agent 在跑,但你知道它們在做什麼,才看得懂 agent 在幹嘛、也才知道要怎麼下指示:
| 指令 | 做什麼 | 新手什麼時候會用到 |
|---|---|---|
npx openfilm | 印出給 agent 看的完整手冊 | agent 不知道怎麼做時叫它重讀 |
npx openfilm open [資料夾或網址] | 用 Studio 開啟一部片(新的、舊的、GitHub 上的都行) | 打開官方範例來玩 |
npx openfilm look [t 或 a-b] | 聯絡表、單格、或一段範圍的檢查 | 「幫我看第 3 到 6 秒」 |
npx openfilm render [a-b] | 輸出 MP4,可加 --4k、--blur、--alpha | 要檔案時 |
npx openfilm get | 用你接好的服務生配音、音樂、音效、圖片、影片 | 需要旁白或配樂時 |
npx openfilm doctor | 印出這台電腦的環境報告 | 回報 bug 時貼上去 |
還有兩個隱藏版:npx openfilm skills 列出可用的影片類型 skill、npx openfilm skill <名稱> 印出那個 skill 的完整做法。這兩個就是下一段 prompt 範本的基礎。
想先看成品長怎樣,直接開官方範例:
npx -y openfilm@latest open https://github.com/openfilm/examples/tree/main/one-prompt
one-prompt 是一支 90 秒的歌詞 MV,每一格都是 WebGL 和 Canvas 畫的,唯一的媒體檔就是那首歌。另一個範例 openfilm-intro 是 1 分 42 秒的官方介紹片,旁白是中文,發布影片 就是用 OpenFilm 從頭做到尾的。
新手 prompt 範本:照 10 個內建 skill 分類

我讀完 10 個內建 skill 之後發現,它們就是最好的 prompt 分類法。每個 skill 都寫了「什麼條件要成立」——例如不能捏造數字、真實產品畫面不能重畫、每個字都要能事後改——所以你在 prompt 裡點名 skill,等於免費附送一份品質規範給 agent。
下面的 prompt 是我依各 skill 的說明寫的範本(不是官方提供的),方括號換成你自己的內容就能用。中英文 agent 都看得懂,我用中文寫比較好改。
寫 prompt 的五個要素
長度(幾秒)、比例(16:9 橫式或 9:16 直式)、用哪個 skill、你的素材放在哪、哪些數字或事實必須照抄。各 skill 都要求 agent 主動問你缺的素材,但「不要因此卡住工作」,所以素材越早給越好。
1. motion-graphics:動態圖像、解說、片頭
適合產品解說、品牌宣傳、數據故事。這是最不需要素材的類型,第一支片我最推薦從這裡開始。
用 OpenFilm 的 motion-graphics skill,做一支 20 秒、16:9 的動態圖像,
主題是「為什麼 USB-C 能同時傳電和傳資料」。只用文字、形狀和線條,
不要配音,配色用深藍底加一個橘色重點色。做完用 look 檢查再給我看。
用 motion-graphics skill 做 30 秒的數據故事:台灣 2020–2025 年的
[某數據],數字如下 [貼上數據]。圖表的形狀必須跟數值一致,
標上單位和資料來源,不准自己補任何數字。
幫我的 YouTube 頻道做一支 5 秒片頭,頻道名稱是 [名稱],
logo 在 assets/logo.png,請照原樣使用不要重畫。
2. keynote:發表會風格產品片
用 keynote skill 做一支 45 秒的產品發表片,產品是 [App 名稱],
截圖在 assets/screens/,官網是 [網址]。一次只講一個賣點,
每個賣點都要有真實畫面當證據。沒上線的功能要標「即將推出」。
用 keynote 風格幫我的開源 CLI 工具做 20 秒介紹,
README 在 ./README.md,所有功能描述只能從 README 來。
3. whiteboard:白板手繪講解
這類需要配音,要先在 Studio 的 Settings → Providers 接一個 TTS 服務。
用 whiteboard skill 把 docs/ohm-law.md 做成 60 秒白板講解,
旁白用中文女聲,每個圖要在旁白講到它的時候才開始畫。
文件裡的公式和數字一個都不能改。
用 whiteboard 風格解釋「TCP 三次握手」,給高中生看,90 秒,
先給我講稿讓我確認,確認後再做配音和畫面。
4. lyric-video:歌詞 MV
用 lyric-video skill 幫 assets/song.mp3 做歌詞 MV,歌詞在 lyrics.lrc。
每個字要在唱到的瞬間出現,做完用數字告訴我對齊誤差多少。
這首歌是 [風格],幫我做一支直式 9:16 的 30 秒歌詞短片,
只取副歌那段(第 45 到 75 秒)。
5. screen-demo:螢幕錄影變產品示範
用 screen-demo skill 把 assets/recording.mp4 剪成 40 秒的功能示範,
把等待載入的時間剪掉,鏡頭跟著滑鼠操作放大。
畫面裡出現的 email、token、其他分頁都要遮掉。
把這段 3 分鐘的錄影剪成 9:16 直式教學,每一步加一行說明字卡,
字要大到手機上看得清楚。
6. presenter-pip:口播+子母畫面
用 presenter-pip skill,我的講話錄影在 assets/me.mp4,投影片在 slides/。
我講到哪一頁就切到哪一頁,我的臉放右下角小窗,不要擋到字幕。
口誤保留,不要幫我剪掉。
7. long-to-short:長片切短影音
用 long-to-short skill 從 assets/podcast.mp4 挑 3 段最適合當短影音的片段,
每段 30–60 秒、9:16,開頭就是最強的那句話。
不准把不同時間講的話拼成一句,告訴我每段在原片的時間點。
8. vintage-film:老底片回憶片
用 vintage-film skill 把 assets/trip/ 裡的 40 張旅行照片做成 60 秒回憶片,
拍立得風格,照原本的拍攝時間排序。日期和地點只能用照片的 EXIF,
讀不到就空著不要猜。
9. collage:剪貼拼貼風
用 collage skill 做一支 20 秒的手帳拼貼風活動預告,
活動資訊:[時間、地點、名稱],照片在 assets/photos/。
10. replicate:照參考影片翻拍
用 replicate skill 參考 references/ad.mp4 的節奏和剪接點,
做一支同樣結構的片,但內容換成我的產品 [名稱]。
參考影片的音樂和畫面都不要直接用。
萬用的修改型 prompt
片子做出來之後,下面這幾句我覺得最好用:
look 一下第 8 到 12 秒,字是不是太小?
第三個鏡頭太快了,延長到 6 秒,後面的片段跟著往後推。
我在 Studio 改了標題的顏色,保留我的修改,只把副標換成 [新文字]。
做一個 9:16 的直式版本,版面重新排,不要只是裁切。
最後一句其實很多人沒想到:小改動不要再 prompt,直接在 Studio 點那個字改掉就好。explainx 的作者也給了同樣的建議——標題、片段長度這種東西手改比再跑一輪 agent 快太多,又不燒 token。
進階玩法:用 NAI Studio 生插圖,做成會動的繪本

這是我最想推的玩法。OpenFilm 內建的素材服務我從原始碼裡數過,studio/server/providers/ 底下有 Azure、Brave、豆包、ElevenLabs、fal、Google、Groq、OpenAI、Pexels、Pixabay、Tavily 加上網頁抓取,沒有 NovelAI。不過手冊寫得很清楚:素材可以來自任何你在用的服務,或你自己的程式,存進 assets/ 就好。
所以流程很單純:用 NAI Studio 把每一頁的插圖生好,放進專案的 assets/,再叫 agent 做成繪本影片。上面那張狐狸走在森林小徑的圖,和下面湖邊看夕陽那張,就是我用 NAI Studio V5 生的,兩張鎖同一個 seed,畫風才會一致:

我用的 tag(NovelAI 吃 danbooru tag,不是一般句子):
第一頁:no humans, fox, forest, walking, path, tree, sunlight, light rays,
        morning, watercolor (medium), storybook, soft colors, green theme
第二頁:no humans, fox, sitting, lake, reflection, sunset, orange sky, cloud,
        grass, watercolor (medium), storybook, soft colors
seed:20261022(兩頁相同)
NAI 生繪本圖的三個小技巧
同一本繪本全部鎖同一個 seed,加上同樣的畫風 tag(像watercolor (medium), storybook),角色和筆觸才不會每頁都換人。尺寸用 landscape(1216×832),在 Opus 訂閱的免費尺寸內;但 V5 模型從 2026-09-20 起有每週用量條,大量生圖前先看一下剩餘額度。另外 tag 要一個詞一個詞查證,猜錯的 tag 會被無聲忽略。
圖放好之後,丟給 agent 的 prompt:
用 OpenFilm 做一支 16:9 的繪本影片《小狐狸的一天》,每頁 6 秒。
插圖依序是 assets/fox-forest.jpg、assets/fox-lake.jpg。
每頁做緩慢的推近和平移(Ken Burns 效果),換頁用溶接。
旁白用中文,溫柔的女聲,每頁一句:
1. 「早晨的陽光穿過樹林,小狐狸出門散步。」
2. 「走了一整天,牠坐在湖邊,看太陽慢慢沉下去。」
字幕要跟旁白同步。圖片不要裁掉狐狸。
如果你好奇 agent 會寫出什麼,其中一頁的 Ken Burns 效果大概長這樣(我依手冊規格寫的示意,假設存成專案根目錄的 page1.html,圖片路徑相對於它)。注意 film.html 裡的 CSS 是靜止的,會動的東西一定要寫在頁面裡,而且只依賴 t:
<!doctype html>
<html>
<head>
<meta charset="utf-8">
<style>
  html, body { margin: 0; width: 1920px; height: 1080px; overflow: hidden; background: #000; }
  img { position: absolute; inset: 0; width: 100%; height: 100%;
        object-fit: cover; transform-origin: 60% 70%; }
</style>
</head>
<body>
<img id="p" src="assets/fox-forest.jpg">
<script type="module">
const img = document.getElementById('p');
window.film = {
  duration: 6,
  ready: img.decode(),                 // 圖片解碼完才開始畫
  frame(t) {
    const k = t / 6;                   // 0 → 1
    img.style.transform = `scale(${1 + 0.08 * k}) translateX(${-30 * k}px)`;
  },
};
</script>
</body>
</html>
旁白和字幕也有規矩:聲音一律是 film.html 裡的 <audio> 片段,頁面本身沒有聲音;字幕是放在音檔旁邊、同檔名的 .vtt(vo/1.wav 對應 vo/1.vtt),由 Studio 產生,手冊明令不准把字幕畫在頁面裡。這點記住,下一段的坑就跟它有關。
已知限制與避坑:GitHub issues 裡的真實回報

一個上線不到三週的專案,第三方評測幾乎沒有。explainx 檢查時 Hacker News 的討論串只有 1 分、0 則留言。所以我覺得最可信的證據反而是 GitHub issues——這些是真的有人踩到、維護者也回應過的問題。
坑一:Windows 渲染慢到懷疑人生
Issue #64 有人在 RTX 5070 筆電上實測:Windows 的 headless Chromium 會退回 SwiftShader 軟體光柵(等於沒用到顯卡),一支 90.9 秒的片子外推要約 45 分鐘;改了幾個設定之後只要 69.5 秒,差了快 39 倍。維護者確認是 bug,隔天就合併了 PR #73 :Windows 改成優先用 Vulkan 跑 GPU,失敗才退回預設,這個 issue 已在 10 月 18 日關閉。所以 Windows 使用者請確定版本在 0.2.1 以上;如果還是很慢,跑 npx openfilm doctor 看渲染器是不是落到 CPU(沒有獨顯的機器本來就會退回軟體渲染)。
坑二:4K 素材把記憶體吃光
Issue #104 :M3 Pro 18 GB 的 MacBook 渲染 6 段 4K HEVC 10-bit 的運動相機素材,整台電腦卡到滑鼠都在抖,最後逾時。0.2.1 已經改成依「當下可用記憶體」配置、保留 2 GB 給你的其他 App、最多開 4 個瀏覽器。請確定版本至少 0.2.1,用 npx openfilm@latest 就會拿到最新版。
坑三:agent 自己 render 出來的 MP4 沒有字幕
Issue #152 抓到一個很有意思的矛盾:手冊叫 agent 不准把字幕畫在頁面裡,但 openfilm render 又沒有燒錄字幕的選項,所以 agent 輸出的 MP4 沒字幕,最後一步得你自己在 Studio 匯出。維護者已接受加 render --subtitles 的提案。在那之前,有字幕的片請從 Studio 匯出,別叫 agent 想辦法繞過去,不然它可能會自己寫一個奇怪的匯出頁面,夭壽難維護。
坑四:Safari 預覽黑屏
Discussion #51 回報 Safari 開 one-prompt 範例預覽全黑,Chrome 正常。官方 README 本來就要求用 Chromium 系瀏覽器(Chrome、Edge),因為渲染引擎就是 Chromium,預覽才會等於輸出。Mac 使用者記得別用 Safari 開 Studio。
坑五:桌面版內建 agent 跑長任務會中斷
Issue #81 :用自己的 key 接 DeepSeek 跑一個多小時後出現「internal error」。查日誌發現是模型思考太久,5 分鐘沒吐任何字就被判失敗。維護者說下一版會放寬到 15 分鐘,並讓每個模型可以設定自己的 context 長度(目前自備 key 的模型一律當 128K 處理)。用推理很慢的模型時,可以先把推理強度調低。
其他要有心理準備的事
決定性靠 agent 自律。look 會抓到大部分問題,但它不是保證——explainx 也特別提醒這點。費用方面,OpenFilm 免費,但官方沒公布「一分鐘影片大概燒多少 token」,第一支片建議做短一點,自己記一下花費。另外它沒有內建影片生成模型,寫實鏡頭要外部生好匯入;而且影片生成很貴,手冊規定要你在 Studio 先確認才會跑。
跟 Remotion、HyperFrames 怎麼選?
這三個都能讓 agent 寫程式做影片,都有 Claude Code skill:
| OpenFilm | HyperFrames | Remotion | |
|---|---|---|---|
| 寫法 | 純 HTML+一個 frame(t) | HTML+CSS+GSAP | React 元件 |
| 授權 | MIT | Apache 2.0 | 小團隊免費,商用分級收費 |
| 內建視覺編輯器 | 有(Studio,可點畫面改字) | 有但較陽春 | 有 Studio,偏開發者 |
| 成熟度 | 不到一個月,迭代超快 | 2026 年 3 月由 HeyGen 開源 | 最成熟,生態最大 |
| 適合 | 想要 agent 做、自己手修的人 | 疊在既有影片上的動態圖像 | 需要雲端大量渲染的團隊 |
yuv.ai 對 HyperFrames 的評測 提到它完整的決定性渲染只在 Linux 成立、視覺編輯器還不成熟,本機渲染 30 秒 1080p 約 3 分鐘。OpenFilm 目前沒有同條件的公開 benchmark,我沒辦法直接比速度,這點要誠實說。
我自己的建議:如果你是新手、想讓 AI 做、自己只想動手改改字和時間,OpenFilm 的 Studio 和「手改會被 agent 保留」這個設計最對胃口。如果你需要穩定的生產線、大量渲染,Remotion 還是比較穩。
第一支片的建議路線

把上面濃縮成一條新手路線:
先用 npx skills add openfilm/openfilm 裝好,打開官方 one-prompt 範例感受一下成品。接著做第一支自己的片——15 到 30 秒、motion-graphics、純文字和形狀、不接任何付費服務,這樣零成本也零風險。做出來後到 Studio 親手改兩三個地方,體會一下「手改+agent 保留」的工作流。熟了再接 TTS 做白板講解,或者像我一樣用 NAI 生插圖做繪本。
OpenFilm 讓我最有感的一點是:它沒有發明新語言,而是賭「agent 本來就很會寫網頁」這件事。從 issue 的回應速度來看——#64 隔天修好、#104 當天就出新版——維護團隊非常積極。專案還很嫩,坑也不少,但一個月不到就能有這個完成度,值得現在就裝起來玩。
你做出第一支片之後,很推薦丟到官方 Discussions 的 Show and tell ,那邊已經有人分享了「網站改版後一條指令重錄、剪輯不用動」的 web-demo skill ,社群玩法比官方文件還有趣。
參考資料
- openfilm/openfilm GitHub repo :README、MANUAL.md、SPEC.md、10 個內建 skill
- OpenFilm 官網 :功能、支援 agent 清單、下載
- openfilm/examples :one-prompt、openfilm-intro 兩個範例
- OpenFilm 發布影片
- explainx:OpenFilm Guide
- AlphaSignal:OpenFilm Lets Coding Agents Build and Edit Videos With Plain HTML
- Issue #64:Windows SwiftShader 渲染慢
- Issue #104:4K 素材耗盡記憶體
- Issue #152:render 無法燒錄字幕
- Issue #81:自備 key 模型長任務中斷
- Discussion #51:Safari 預覽黑屏
- yuv.ai:HeyGen HyperFrames 介紹


沒有留言:
張貼留言