
最貴的 Claude 模型,在第三方智慧指數上輸給了便宜 2.5 倍的那一個。
這不是我亂講。Artificial Analysis 的 Intelligence Index v4.3.2 官方頁面,2026 年 10 月的前五名長這樣:Claude Opus 5.5(max effort,開 default fallback)58 分排第一,Sonnet 5.5(同設定)56 分排第二,Opus 5.5 的 xhigh 也是 56。至於每百萬 token 要價 10 美金輸入、50 美金輸出的 Fable 5.1?AA 首頁前五名裡沒有它,aivy 的追蹤文 引用 10 月 18 日的 AA 讀數,max 對 max 是 Opus 5.5 的 57.62 對 Fable 5.1 的 53.35(這是二手整理,我在 AA 頁面上沒看到 Fable 的直接列表,信心打個折)。
我第一次看到這個排名的反應是:真假?Anthropic 自己的定位不是「Fable 是最強的」嗎?結果翻完官方文件之後發現,Anthropic 自己公布的 SWE-bench Pro 數據講的是同一件事:Opus 5.5 用對策略能解 97%、每題 $0.17,Fable 5.1 預設跑一次 92.3%、每題 $1.19。Anthropic 沒有騙人,是我們一直用錯的心智模型在選模型。這篇就是把這件事拆開來講:2026 年 10 月當下,Claude 的 Fable 5.1、Opus 5.5、Sonnet 5.5、Haiku 5.5 到底各自站在哪裡,在 Claude Code、API、claude.ai 三個地方要怎麼設定才不會白燒錢。
先講結論,省得你往下滑:不是四個模型選一個,是「Opus 5.5 當主力、effort 當旋鈕、caching 和 batch 當幾乎免費的槓桿」。Fable 5.1 是例外工具,不是升級品。
本文前提
以 2026-10-21 的 Anthropic 官方文件、Claude Code v2.1.293 與 Artificial Analysis v4.3.2 為準。Claude Code 的別名解析每隔幾週就會變,文中版本號請當作時間戳而不是永久真理。價格全部是 Anthropic 第一方 API 的美金牌價,Bedrock 和 Vertex 另計。
2026 年 10 月的陣容,一張表看完

先把官方 Models overview 的數字攤開。四個現役模型全部是 1M context、128K 最大輸出、知識截止 2026 年 6 月,差別在價格、速度、預設 effort 和定位。
| 模型 | 輸入 / 輸出($/MTok) | 快取讀取 | 預設 effort | 延遲 | 官方定位 |
|---|---|---|---|---|---|
| Fable 5.1 | 10 / 50 | 0.25 | high | 最慢 | 高難度推理、跑數小時的代理任務 |
| Opus 5.5 | 4 / 20 | 0.20 | medium | 中 | 長時間代理編碼與知識工作 |
| Sonnet 5.5 | 2 / 10 | 0.10 | high | 快 | 速度與智慧的最佳組合 |
| Haiku 5.5 | 0.10 / 0.50 | 0.01 | medium | 最快 | 分類、擷取、路由、子代理 |
還有一個 Mythos 5.1,跟 Fable 5.1 同能力同價格,但只開放給通過 Cyber Verification Program 這類驗證的組織,一般人看看就好。
這張表有兩個地方值得停下來看。一是 Opus 5.5 和 Haiku 5.5 的預設 effort 是 medium,Fable 5.1 和 Sonnet 5.5 是 high,這個不對稱後面會害到人。二是 Haiku 5.5 那個 0.10 的價格有附帶條件:prompt 超過 100K token 之後,輸入輸出全部乘以五。
官方 Models overview 寫得很直白:「If you're unsure which model to use, start with Claude Opus 5.5 for most workloads.」Choosing the right model 那頁的選模矩陣第一行也是「Most workloads start with Claude Opus 5.5.」而且 Claude Code 的模型設定文件 寫明從 v2.1.280 起,Pro、Max、Team、Enterprise、API 所有帳號型態的預設都是 Opus 5.5,還特別加了一句:「Neither Fable model is the account-type default on any plan or provider.」
Anthropic 自己在 ClaudeDevs 的推文 裡說得更直接:Opus 5.5「performs at the level of Fable 5.1」,而且比 Opus 5 便宜 40%、快 30%。所以官方、Claude Code 預設、第三方指數,三方交集都是同一個答案。
真正該轉的旋鈕是 effort,不是模型

我以前的習慣是「這題好難,換大一點的模型」,現在 官方選模頁 直接打臉:「Tuning effort is often a better lever than switching models.」
Anthropic 在 Optimizing for cost and intelligence 這頁公布了一組 SWE-bench Pro 的實測(478 題子集,2026 年 8 月到 10 月跑的),我把關鍵幾行抄下來:
| 策略 | 解題率 | 每題成本 |
|---|---|---|
| Opus 5.5 全部跑 high | 94.8–95.8% | 約 $0.29 |
| Opus 5.5 先跑 low,失敗的再用 high 重跑 | 96.4–97.5% | 約 $0.17 |
| Opus 5.5 先跑 medium,失敗再 high | 96.0–97.1% | 約 $0.24 |
| Opus 5.5 low 跑一次 | 87.4% | $0.12 |
| Sonnet 5.5 預設跑一次 | 87.6% | $0.11 |
| Fable 5.1 預設跑一次 | 92.3% | $1.19 |
看到沒?「低 effort 全跑、失敗再用 high 重跑」比「全部跑 high」解得更多,成本只要六成。注意 Opus 5.5 單跑 low 只有 87.4%,這個策略的省錢來自「失敗再重跑」那一半,不是 low 本身夠強。Fable 5.1 跑一次解 92.3%,但每題要 1.19 美金,是 Opus 5.5 escalation 策略的七倍價錢,解題率還比較低。
成本頁 的建議順序也寫得很清楚:「Tune one model before you add a second: sweep effort on your current model first, because most workloads end there, and if the sweep shows a gap, price the stronger model alone at low effort.」先在同一個模型掃 low、medium、high,大部分工作在這一步就結束了。真的有缺口,先試「更強的模型開 low」,最後才考慮多模型配對。
這個策略有一個前提:你要有可靠的檢查器判斷「失敗」。同一頁也補了一句「a checker that passes bad work lets those failures through」。測試跑綠就算過的場景很適合,寫文章這種沒有客觀對錯的就不行。
Effort 怎麼開?Claude Code 裡是 /effort low|medium|high|xhigh|max,API 是 output_config.effort。Fable 5.1、Opus 5.5、Sonnet 5.5、Haiku 5.5 全部支援五檔。
Fable 5.1 什麼時候才值得

講到這裡你可能會問:那 Fable 5.1 存在的意義是什麼?
官方 What's new in Claude Fable 5.1 的說法是:「Use Claude Fable 5.1 for demanding reasoning and long-horizon agentic work, or when your evals on Claude Opus 5.5 at higher effort still fall short.」注意那個條件句,是「Opus 5.5 開到 xhigh 或 max 跑過 evals 還不夠」才上 Fable,不是一開始就上。
每日評測 Opus 5.5 的 every.to 團隊 給了更具體的分界。測試者 Kieran 把 Opus 5.5 估在「about 90 percent as capable as Fable at coding」,而且直接改成日常主力。另一位 Mike Taylor 仍認為 Fable 在最大的問題上明顯更聰明,文章列出的三個留在 Fable 的條件是:「The problem is too big to eyeball」、「The deliverable has to be right the first time」、「You prefer Fable's prose」。肉眼檢查不了的、一次就要對的、散文品質要求高的,這三種才上 Fable。
但 Fable 5.1 有三種成本是一般人沒算到的。
錢只是第一種。輸入輸出都是 Opus 5.5 的 2.5 倍,官方成本頁的內部代理編碼基準 顯示 Opus 5.5 預設每次嘗試的成本「under a third as much per attempt as Claude Fable 5.1 at medium」。
第二種是分類器。Fable 系列掛著 cyber、bio、reasoning_extraction 等安全分類器,被擋的請求會回 HTTP 200 加 stop_reason: "refusal",不是報錯,你的程式不檢查就會把空回應當成功。Anthropic 在 Redeploying Fable 5 裡承認新加的分類器「comes at the cost of flagging benign requests more often during routine coding and debugging tasks」,誤判是存在的。
第三種是政策風險,這個對台灣用戶特別重要。2026 年 6 月 12 日,美國商務部對 Fable 5 和 Mythos 5 下了出口管制,要求任何外國人存取都要有許可證。Anthropic 沒辦法即時驗證國籍,當天就全球停用 兩個模型,連自家外籍員工都用不了。根據 Redeploying Fable 5 ,管制在 6 月 30 日解除,7 月 1 日恢復。前後兩週半,如果你的 pipeline 綁死在 Fable 上,就是整整兩週半開天窗。Opus 5.5 沒有被管制過。不過要說清楚,Opus 5.5 自己也掛著 Fable 級的 cyber 和 bio 分類器,every.to 提到大部分資安任務會被轉送到 Opus 4.8,所以常做資安工作的人,分類器這一關哪個模型都躲不掉,差別只在有沒有被政府關過。
最後是訂閱方案的計費方式。根據官方 Claude Fable models on your plan ,Pro 方案用 Fable 要另外開 usage credits 付錢,不在方案額度內;Max 和 Team premium 座位可以用週額度的最多 50% 跑 Fable,而且官方明講 Fable「use them faster than other Claude models」。
所以我現在的用法是:Fable 5.1 當單次任務工具。/model fable 跑完那個特別硬的東西,馬上切回 opus。不當日常,不綁 pipeline。
Sonnet 5.5 和 Haiku 5.5 的正確位置

Sonnet 5.5 被低估了。前面 SWE-bench Pro 那張表裡,Sonnet 5.5 預設跑一次 87.6%、每題 $0.11,跟 Opus 5.5 開 low 幾乎一樣(87.4%、$0.12)。the-decoder 的報導 整理了 Anthropic 發布的數字:Terminal-Bench 4.0 上 Sonnet 5.5 的 70.6% 甚至反超 Opus 5.5 的 66.4%,CursorBench 和 FrontierCode 則是 Opus 領先。範圍明確、可驗證的日常工作,Sonnet 5.5 是 CP 值王。
但它有兩個 effort 邊界要記住。ComputingForGeeks 的實測 用 k3s 部署任務跑了三次:Sonnet 5.5 在 low 三次全掛,medium 以上九次全過。所以日常工作不要為了省錢降到 low。另一頭也有問題:FrontierCode 上 Sonnet 5.5 的 max(46.2%)反而輸給 xhigh(52.1%),原因是 max 會觸發子代理審查,導致超時或越界修改。開 max 不一定比較強,這點跟直覺相反。所以 Sonnet 5.5 的甜蜜點就是預設的 high,省額度時降到 medium,想加碼頂多到 xhigh。
另外同一份官方內部代理編碼基準(369 題、每題 5 次嘗試)顯示,Sonnet 5.5 預設 77.8%,比 Opus 5.5 預設低約 9 分,成本約五分之二。要不要省這筆,看你的任務是「範圍明確」還是「開放探索」。
Haiku 5.5 的定位是分類、擷取、路由、子代理。官方成本頁的 GPQA Diamond 量測 裡它單獨能拿 85%(Opus 5.5 是 91%),已經不是什麼笨模型。What's new in Haiku 5.5 寫得很清楚:價格比 Haiku 4.5 降最多 90%,最小可快取長度從 4096 降到 512 token,短 prompt 也吃得到快取。
但 Haiku 5.5 有一個會反咬的陷阱。官方成本頁的 Managed Agents 案例裡,約 5% 的請求 prompt 超過 100K token,這 5% 的請求佔了 73% 的成本。因為 官方定價頁 寫明超過 100K 之後輸入輸出全部乘五。你把 Haiku 當成「便宜就隨便塞」,塞了整個 repo 進去,帳單就不便宜了。
Claude Code 實戰設定
講完選擇邏輯,來講怎麼按。以下全部以 Claude Code 官方 Model configuration 為準。
別名對照(Anthropic API 下):opus 是 Opus 5.5、sonnet 是 Sonnet 5.5、haiku 是 Haiku 5.5、fable 是 Fable 5.1(需 v2.1.257 以上)。best 是有 Fable 就用 Fable、沒有就 Opus。opusplan 是規劃階段用 Opus、執行階段切 Sonnet。default 不是模型,是清掉覆寫回到帳號預設。
我目前用的日常組合(這是照官方 effort 預設和額度邏輯推的,不是跑過 benchmark):
/model opus          # 主力 Opus 5.5
/effort medium       # 日常編輯、問答(Opus 5.5 預設就是 medium)
/effort high         # 多檔修改、除錯時手動升
/effort xhigh        # 真正難的問題才開
子代理的部分是省額度的大頭。官方文件說子代理請求「count toward the same usage limits as your main conversation」,而內建的 Explore 代理預設跑主對話的模型,也就是 Opus。兩個設定可以省很多:
// ~/.claude/settings.json
{
  "env": {
    "CLAUDE_CODE_SUBAGENT_MODEL": "haiku"
  }
}
然後自訂一個名為 Explore 的子代理,frontmatter 寫 model: haiku,它會覆蓋內建的 Explore。這招是 官方 sub-agents 文件 自己教的。
子代理模型的解析順序在 v2.1.251 之後改了:per-invocation 參數優先,再來是 frontmatter 的 model,再來才是 CLAUDE_CODE_SUBAGENT_MODEL 環境變數,最後是主對話模型。如果你要強制所有子代理同一個模型,加 CLAUDE_CODE_SUBAGENT_MODEL_FORCE=1。
額度機制也值得知道。Opus 5.5 上線時 5 小時額度加了 20%,而且每位訂閱者多了一次可以自選時機的 reset,留給大型重構用。effort 直接決定燒速,一個 medium 的 session 和一個 xhigh 的 session 用掉同一個 5 小時窗口的速度差很多。Pro 方案如果 Opus 燒太快,/model sonnet 切回去,設定會記住。
最大的省錢動作其實是 /clear。1M context 聽起來很爽,但每一輪都要重送整段對話,auto-compact 門檻約 967K。buildthisnow 的 Opus 5.5 額度拆解 也把「不同任務之間清掉或 compact context」列為最大的槓桿,我自己的經驗是通常比換模型省得更多。
opusplan 的隱藏成本
根據 What's new in Opus 5.5 ,Opus 5.5 的 thinking block 只有 Fable 5.1 和 Mythos 5.1 讀得懂。opusplan 從 Opus 規劃切到 Sonnet 執行時,Opus 階段的推理會被丟掉(不計費、不報錯,但就是沒了)。計畫寫成文字的部分會留著,所以不是完全沒用,但不要期待 Sonnet 繼承 Opus 的思路。
API 寫法的七件事
如果你是寫程式呼叫 API,情況比 Claude Code 複雜一點,因為 Claude Code 幫你做掉的 caching、thinking block 回傳、refusal 處理,全部要自己來。我把它壓成七件事,順序是刻意排的:前三件幾乎不花錢,後四件是避免踩雷的。
一、模型字串固定 claude-opus-5-5,output_config.effort 顯式設定,不要依賴 medium 預設。
二、caching 先開,再談任何最佳化。官方成本頁 的 DeepResearch Bench II 數據:Fable 5.1 每任務成本從 $37.94 降到 $6.89,光靠 prompt caching。agent loop 一整天的輸入中位數有 84% 來自快取。任何會變動的東西(時間戳、佇列位置)放在最後一個 cache breakpoint 之後。同一頁實測一行 25 token 的狀態列放在 system prompt 開頭,單次工作從 $0.59 變 $4.24,快取全滅。
三、沒人在等的請求全部走 Batch API,半價,24 小時內回。
四、採「low 全跑、失敗再 high 重跑」策略,前提是有可靠的檢查器。
五、Fable 5.1、Opus 5.5、Sonnet 5.5 都不支援 tool_choice: any 或 tool,不支援 prefill,不支援非預設 temperature。thinking block 要原樣回傳,對話保持 append-only。2026 年 8 月 31 日之後建立的帳號,編輯歷史會直接回 400。
六、設 fallbacks: "default" 加 server-side-fallback-2026-07-01 beta header 處理分類器誤判,寫法在 官方 Refusals and fallback 頁。Fable 5.1 的許可 fallback 目標是 Opus 4.8 和 Opus 5(Fable 5.1 what's new 有列);Haiku 5.5 沒有 server-side fallback,要用 SDK middleware 或自己 retry。
七、用 Models API 的 capabilities 欄位查能力,不要硬記哪個模型支援什麼。
一個最小可用的 Python 範例,把前面幾點串起來:
# pip install anthropic
import anthropic

client = anthropic.Anthropic()

response = client.beta.messages.create(
    model="claude-opus-5-5",
    max_tokens=16000,
    output_config={"effort": "low"},          # 先跑 low,失敗再升 high
    betas=["server-side-fallback-2026-07-01"],  # 官方 refusals-and-fallback 頁的 beta 名稱
    fallbacks="default",                       # 分類器誤判時自動轉模型(Claude API 限定,Batch 不支援)
    system=[{
        "type": "text",
        "text": STABLE_SYSTEM_PROMPT,          # 固定內容放前面
        "cache_control": {"type": "ephemeral"},
    }],
    messages=[{"role": "user", "content": task}],  # 會變的放後面
)

if response.stop_reason == "refusal":
    handle_refusal(response.stop_details)
elif response.stop_reason == "max_tokens":
    retry_with_higher_effort()
else:
    for block in response.content:
        if block.type == "text":             # 不要用位置取,用 type 取
            print(block.text)
訂閱方案怎麼配
claude.ai 的方案跟模型可用性,綜合官方 Pro 、Max 文件和第三方整理:
| 方案 | 月費 | 模型 | Fable 計費 |
|---|---|---|---|
| Free | $0 | Sonnet / Haiku | 不可用 |
| Pro | $20 | Opus 5.5(預設)/ Sonnet / Haiku | 須開 usage credits 另付 |
| Max 5x / 20x | $100 / $200 | 全部 | 週額度最多 50% 可跑 Fable |
| Team / Enterprise premium | 另議 | 全部 | 同 Max |
| Team / Enterprise standard | 另議 | 全部 | 須 usage credits |
表格來源說明:Fable 那一欄是官方 Fable 方案文章;Pro 預設 Opus 5.5 來自 Claude Code 文件;Free 只有 Sonnet 和 Haiku 是第三方整理,官方頁沒有明列。
一個小細節:Max 20x 的「20 倍」是對 5 小時 session 算的,不是對週。第三方 wokey.ai 的量測 發現 Max 20x 的單一 5 小時窗口約 Pro 的 15 倍,整週只有 9.7 倍。買之前先想清楚你的使用型態是「偶爾爆衝」還是「每天穩定用」。
決策流程
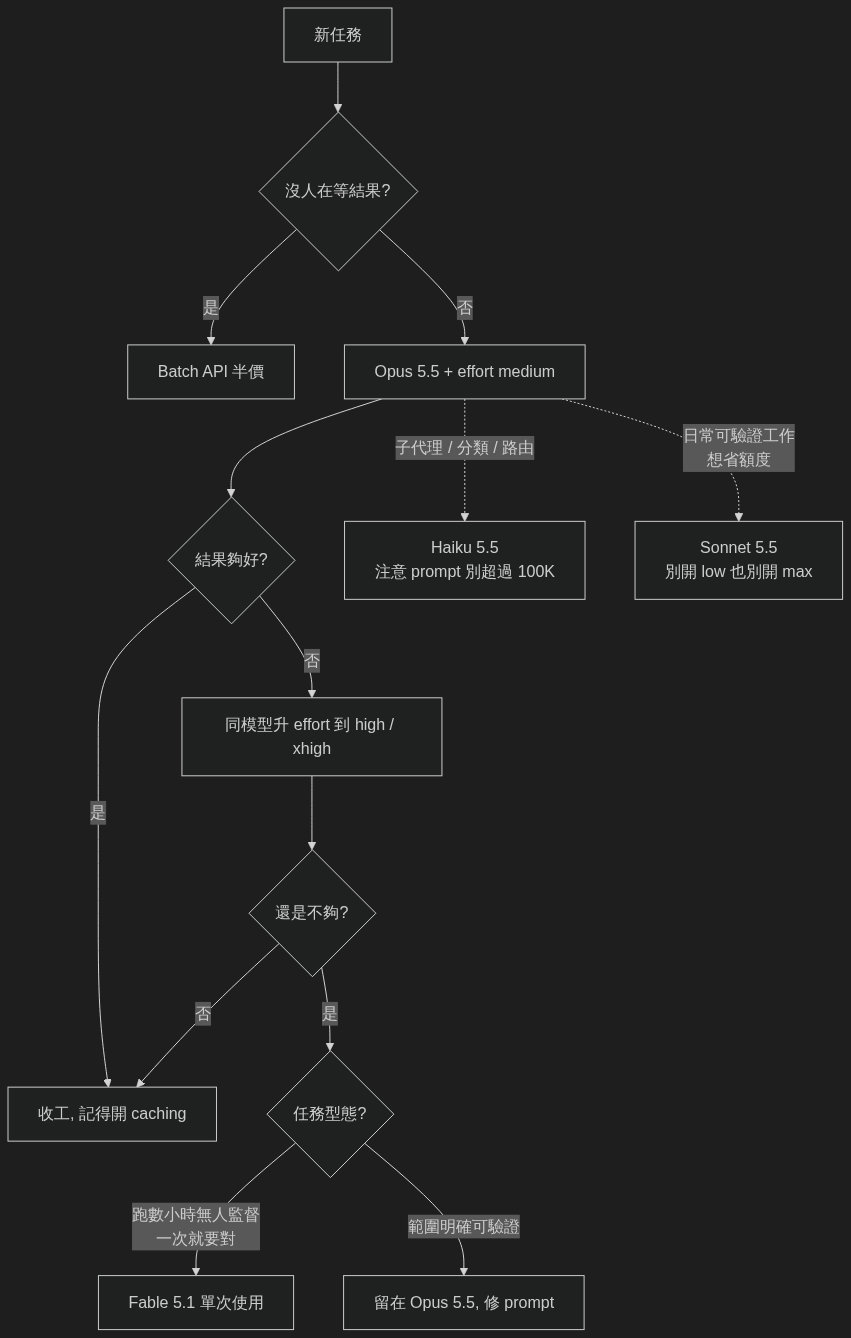
把上面所有東西壓成一張圖:
踩坑紀錄

這段混了兩種來源:前四個是我讀官方文件時差點誤會、或是文件自己承認的坑,最後一個是 every.to 測試者的實際案例。照「現象、原因、解法」排。
從 Opus 5 遷移到 Opus 5.5,感覺變笨了。 原因是 Opus 5.5 預設 effort 是 medium,Opus 5 是 high。你沒顯式設定,就等於默默降了一檔。解法:遷移後重跑 effort sweep。如果你是從 Opus 5 的 high 搬過來、明顯感覺變笨,Claude Code 裡 /effort high 設回去;如果是新開始用,就從 medium 起,變笨了再升。官方 What's new in Opus 5.5 還補了一句,Opus 5.5 在同一 effort 下比 Opus 5 想得更多,尤其 xhigh 和 max,省下的 20% 單價可能被多出來的 thinking token 吃回去。
Haiku 5.5 的帳單比預期高好幾倍。 原因是某些請求的 prompt 超過 100K token,價格乘五。解法:子代理任務切小一點,或在呼叫前算 token 數,超過 100K 就換 Sonnet(Sonnet 全 1M 窗口都是標準價)。
Prompt caching 開了但 cache_read_input_tokens 一直是零。 原因是 system prompt 開頭放了會變的東西,像時間戳或狀態列。解法:固定內容放前面、變動內容放最後一個 breakpoint 之後。官方實測這個錯誤讓單次工作貴七倍。
Fable 5.1 跑 agent loop 一輪只發一個 tool call,比 Fable 5 慢。 這是官方承認的行為變化,「Parallel tool calling is more variable」。解法:在 prompt 加一行要求獨立的讀取批次執行,官方 Prompting Claude Fable 5.1 有範例。
Opus 5.5 說做完了,但 app 跑起來是壞的。 every.to 的 Mike 要了一個語音輸入的表單 app,30 分鐘、約 590 萬 token 之後,登入頁看起來乾淨、自動檢查全綠,但實際打開,核心的 builder 和 interview 畫面直接報錯,而且根本沒呼叫該呼叫的 AI 服務。他們給的建議很乾脆:「read the diff and run the app before you call it done」。這不是模型問題,是「自我驗證不可靠」這件事在 Opus 5.5 上一樣存在。
結語

這篇文章的保存期限大概是三個月。Claude Code 的別名解析在 v2.1.280、2.1.284、2.1.293 連續三個版本換了三次模型,Opus 5.5 把 Opus 5 的 high 預設改成 medium 也沒有大張旗鼓宣布,就靜靜寫在 what's new 裡。下一次改版,這篇的每個數字都要重查。
所以比起記住「哪個模型最好」,更值得花時間的是建一套自己的量尺。具體做法是這樣:挑十到三十個你真實工作裡的任務,韌體除錯、PCB 檢查、規格書摘要都行,每個任務寫下「怎樣算對」。然後同一個模型跑 low、medium、high 各一輪,記下解題率和 token 用量。從此之後每次 Anthropic 改版,你只要重跑一輪,就知道該不該換設定,不用再看別人的 benchmark 猜。
如果你跑完 sweep 發現你的任務型態跟我寫的不一樣,例如 Sonnet 5.5 在你的場景 low 就夠用,或是 Fable 5.1 在某類任務上真的值回票價,那才是最有價值的資訊。
參考資料
- Models overview - Claude Platform Docs
- Choosing the right model - Claude Platform Docs
- Optimizing for cost and intelligence - Claude Platform Docs
- Pricing - Claude Platform Docs
- What's new in Claude Fable 5.1
- What's new in Claude Opus 5.5
- What's new in Claude Haiku 5.5
- Refusals and fallback - Claude Platform Docs
- Claude Code - Model configuration
- Claude Code - Subagents
- Claude Fable models on your plan - Claude Help Center
- What is the Pro plan? - Claude Help Center
- What is the Max plan? - Claude Help Center
- Cyber Verification Program - Claude Help Center
- Statement on the directive to suspend Fable 5 access - Anthropic
- Redeploying Fable 5 - Anthropic
- Artificial Analysis Intelligence Index
- Claude Opus 5.5 vs Fable 5.1: which is better, and when to pay for Fable - aivy
- Vibe Check: Opus 5.5 Is Pulling Our Codex Converts Back to Claude - every.to
- Anthropic's Claude Sonnet 5.5 nearly matches Opus 5.5 on benchmarks - the-decoder
- Claude Sonnet 5.5 Released: Benchmarks, Pricing, vs Opus 5.5 - ComputingForGeeks
- Claude Usage Limits (October 2026) - wokey.ai


沒有留言:
張貼留言