
先講結論,省得你滑到最後:在一片 8GB 的 RK3588 板子上,用 NPU 跑得最聰明的是 Qwen3-4B-Instruct-2507,我出的 7 題全對,但每秒只吐 3.7 個 token。 想要順一點的對話體驗,Qwen3.5-2B 的 8.4 tok/s 是比較甜的平衡點;最新的思考模式呢?答得準,但一題要等兩三分鐘,在這塊板子上基本不能用。
這篇是我把一片 Radxa ROCK 5C 從出廠映像檔,一路弄到能跑 RKLLM 和 YOLOv8 的完整紀錄。中間踩了四個坑,其中一個很陰險:用舊版工具轉的模型,放到新版 runtime 上,只要寫到半形逗號就自己閉嘴。 回答「玉山海拔大約為 3,」就結束了,整個傻眼。
如果你手上也有 RK3588(ROCK 5B/5C、Orange Pi 5、Turing RK1 之類),想在本地跑 LLM,這篇應該能幫你省下半天。
環境與前置條件
| 項目 | 規格 |
|---|---|
| 板子 | Radxa ROCK 5C,RK3588S2(4×A76 + 4×A55),RAM 8GB |
| NPU | 6 TOPS,3 核心 |
| 系統 | Radxa 官方 Debian 12(bookworm)桌面映像檔 |
| kernel | 6.1.43 → 升到 6.1.84-8 |
| NPU 驅動 | v0.9.6 → 升到 v0.9.8 |
| RKLLM | v1.2.3 與 v1.3.0 兩版並存 |
| rknn-toolkit2 | 2.3.2(aarch64,直接裝在板子上) |
根據 Radxa 官方介紹 ,ROCK 5C 標準版用的是 RK3588S2,Lite 版則是只有兩顆大核的 RK3582,買之前要看清楚。CNX Software 的整理 也列得很清楚:NPU 標準版 6 TOPS、Lite 版 5 TOPS。
整體流程長這樣:
出廠映像(NPU 0.9.6)
  → apt full-upgrade → kernel 6.1.84 / NPU 0.9.8
  → RKNN:YOLOv8 暖身
  → RKLLM runtime v1.2.3 / v1.3.0
  → 下載社群轉好的 .rkllm 模型
  → 鎖頻 + 7 題實測
第一關:NPU 驅動要先升到 0.9.8
Radxa 的 RKLLM 安裝文件 寫得很明白:RKLLM 需要 NPU 驅動 v0.9.8,而 Radxa 6.1 系列的韌體只有 0.9.6。我這片的出廠映像檔是 2024 年 8 月的版本,一查果然:
sudo cat /sys/kernel/debug/rknpu/version
# RKNPU driver: v0.9.6
文件叫你開 rsetup 選 System Update,其實背後就是 apt full-upgrade。我這片一共有 440 個套件可以更新,包括新的 kernel 6.1.84 和 rknpu2 2.3.0。既然要遠端操作,我就直接用非互動模式跑:
sudo apt update
sudo DEBIAN_FRONTEND=noninteractive apt-get -y \
  -o Dpkg::Options::=--force-confdef \
  -o Dpkg::Options::=--force-confold full-upgrade
sudo apt install -y rknpu2-rk3588 python3-rknnlite2
sudo reboot
聽起來很簡單對吧?結果第一次跑,SSH 直接斷線,板子叫不醒。
坑 1:桌面版映像檔會自己去睡覺
我後來翻 journal 才看懂發生什麼事:apt 在 13:01:11 開始跑,才 5 秒,dpkg 剛開始解壓套件,GDM 的 gsd-power 就讓系統進了 sleep.target。Radxa 的桌面映像檔預設會在登入畫面閒置後自動休眠,這對拿來接螢幕的人很合理,對拿來當無頭伺服器的人就是陷阱。夭壽,更新跑到一半被休眠打斷,dpkg 還留了三個沒處理完的 trigger。
好在損害不大,處理方式是先把休眠整個關掉,再把 dpkg 修好:
sudo systemctl mask sleep.target suspend.target hibernate.target hybrid-sleep.target
sudo dpkg --configure -a
⚠️ 無頭使用前先 mask 休眠
用 Radxa 桌面映像檔當伺服器時,第一件事就是 mask 掉 sleep.target。之後想恢復,改成 unmask 就好。
坑 2:長時間的工作不要掛在 SSH session 底下
第二次我學乖了,用 systemd-run 在背景跑更新。但後來下載模型時又踩到一個類似的雷:我用的是 systemd-run --user,結果下載卡在 87MB 不動。原因是 --user 服務掛在使用者 session 底下,SSH 一斷,服務就跟著被收掉。改成系統層級、再指定使用者就沒事了:
sudo systemd-run --unit=rk-upgrade --collect -p User=radxa \
  -p StandardOutput=append:/home/radxa/upgrade.log /home/radxa/upgrade.sh
更新完、重開機(新 kernel 第一次開機大概要 3 分半,別急著拔電),驅動就到位了:
sudo cat /sys/kernel/debug/rknpu/version
# RKNPU driver: v0.9.8
暖身:YOLOv8 在板子上一條龍跑完
在碰 LLM 之前,我先用 Radxa 的 YOLOv8 教學 驗證 NPU 環境。文件的寫法是在 x86 PC 上轉模型、交叉編譯,再傳到板子上跑。
但其實不用這麼麻煩。Radxa 的 RKNN 安裝文件 本身就有提到,rknn-toolkit2 2.3.2 有 manylinux aarch64 的 wheel,轉換可以直接在板子上做。ROCK 5C 有 8GB RAM,轉 yolov8n 這種小模型綽綽有餘:
# 環境
sudo apt install -y python3-venv python3-dev gcc g++ cmake make
git clone --depth 1 -b v2.3.2 https://github.com/airockchip/rknn_model_zoo.git
python3 -m venv ~/rknn-venv && . ~/rknn-venv/bin/activate
pip install rknn-toolkit2==2.3.2

# 下載 ONNX、轉成 rknn(int8 量化)
cd rknn_model_zoo/examples/yolov8/model && bash download_model.sh
cd ../python && python convert.py ../model/yolov8n.onnx rk3588

# 用板子上的 gcc 原生編譯 C demo,不需要交叉編譯器
cd ../../.. && export GCC_COMPILER=aarch64-linux-gnu
bash build-linux.sh -t rk3588 -a aarch64 -d yolov8

# 執行
cd install/rk3588_linux_aarch64/rknn_yolov8_demo
LD_LIBRARY_PATH=./lib ./rknn_yolov8_demo model/yolov8.rknn model/bus.jpg
轉換在板子上只花了 24 秒。輸出跟官方文件的預期結果一字不差:
person @ (211 241 282 506) 0.864
bus    @ (96 136 549 449) 0.864
person @ (109 235 225 535) 0.860
person @ (477 226 560 522) 0.848
person @ (79 327 116 513) 0.306
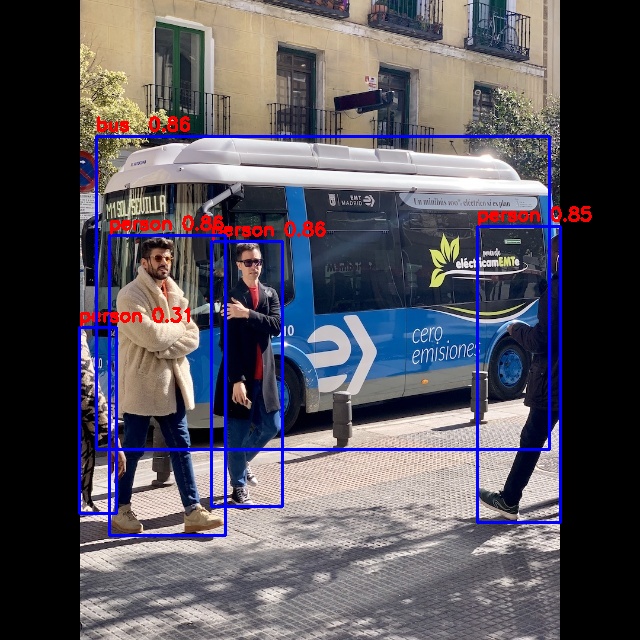
我用 RKNNLite 寫了個簡單的 Python 迴圈量速度,大約 36 ms 一張,約 28 FPS。這裡要老實講,這個數字包含 Python 的呼叫開銷,而且是單執行緒送一張等一張。有人在 rknn_model_zoo 的 issue #454 分享過,用 3 核 NPU 加上 MPP 解碼、RGA 縮圖的零拷貝管線,YOLOv8n 在 640 解析度可以跑到約 199 FPS。所以 28 FPS 只是入門數字,你認真優化,天花板高很多。
💡 中國 CDN 的下載坑
download_model.sh 的 ONNX 放在中國的 CDN。我的板子一開始走國外 VPS 出去,30 秒只下載了 65KB。遇到這種狀況,先在電腦上下載再 scp 過去最快。
主戲:RKLLM v1.2.3 還是 v1.3.0?
Radxa 文件寫的是 RKLLM v1.2.3,但我去 rknn-llm 的 Releases 頁面 一看,Rockchip 在 2026-06-17 已經發了 v1.3.0,新增支援 Qwen3.5、Gemma4、SmolLM3。這幾個正好是目前最新的小模型,當然要升。
RKLLM-Toolkit(轉模型用的工具)只支援 x86_64 Linux,所以這次我全部用社群轉好的 .rkllm 模型,runtime 則直接裝在板子上:
git clone --depth 1 -b release-v1.3.0 https://github.com/airockchip/rknn-llm.git rknn-llm-1.3.0
cd rknn-llm-1.3.0
sudo cp rkllm-runtime/Linux/librkllm_api/aarch64/librkllmrt.so /usr/lib/
sudo cp rkllm-runtime/Linux/librkllm_api/include/rkllm.h /usr/include/
sudo /sbin/ldconfig

# 官方 build-linux.sh 寫死了 x86 交叉編譯器,在板子上直接用 cmake
cd examples/rkllm_api_demo/deploy && mkdir build && cd build
cmake .. -DCMAKE_BUILD_TYPE=Release -DCMAKE_C_COMPILER=gcc -DCMAKE_CXX_COMPILER=g++
make -j8
./llm_demo <model.rkllm> 768 4096
坑 3:舊模型配新 runtime,寫到半形逗號就閉嘴
這是整個實測裡最陰險的一個。我用 v1.3.0 runtime 跑用 toolkit 1.2.3 轉的 Qwen3-4B-Instruct-2507,問它台灣最高的山,它回:
台灣最高的山是玉山,其海拔大約為3,
然後就沒了。我一開始以為是輸出被截斷,翻 log 才發現這題真的只生成了 16 個 token,是模型自己送出了結束符號。問 strawberry 有幾個 r,它寫到「s,」也停了。
同一個模型換回 v1.2.3 runtime,一切正常:
| 模型(toolkit 1.2.3 轉) | v1.3.0 runtime | v1.2.3 runtime |
|---|---|---|
| Qwen2.5-1.5B | 「海拔高度為3,」後結束 | 「3952 公尺」完整回答 |
| Qwen3-4B-2507 | 「海拔大約為3,」後結束 | 「3,952 公尺」完整回答 |
有趣的是,用 v1.3.0 轉的 Qwen3.5 寫「3,952」完全沒問題。v1.3.0 的 release note 有一條「新增多 EOS token ID 支援」,我猜跟這個有關,但沒辦法百分之百確認。實務上的結論很簡單:runtime 版本要跟轉檔版本對上。 我的做法是兩版並存:~/rknn-llm 的舊 demo 透過 rpath 指向自己資料夾裡的 v1.2.3 函式庫,系統預設的 /usr/lib/librkllmrt.so 則是 v1.3.0,互不干擾。
坑 4:沒鎖頻,速度只有官方的七成
第一次跑 Qwen2.5-1.5B 只有 12.2 tok/s,跟 官方 benchmark 的 16.69 差了一截。原來官方測之前都會跑一支鎖頻腳本,把 CPU、NPU、DDR 全部固定在最高頻率:
sudo bash ~/rknn-llm-1.3.0/scripts/fix_freq_rk3588.sh
鎖完再跑,12.2 直接跳到 16 tok/s 以上(7 題平均 16.2),跟官方幾乎一樣。鎖頻後滿載時 SoC 溫度大約 49°C,完全沒降頻,風扇甚至沒轉。代價是閒置時也不會降頻,比較耗電,重開機就會恢復。
實測:5 個模型 + 思考模式,誰最聰明?
測試方法
我從官方的 llm_demo.cpp 複製一份改成測試工具,讓思考模式可以用環境變數切換(設定 RKLLMInput 的 enable_thinking)。解碼用 demo 預設的 top_k=1,也就是貪婪解碼,每次輸出都固定,比較起來才公平。每個模型都在鎖頻、沒有其他工作的狀態下獨立跑。
題目是 7 題繁中,刻意混了幾個小模型常翻車的陷阱:
- 雞兔同籠:14 個頭、38 條腿(答案:雞 9、兔 5)
- 台灣最高的山和海拔(玉山,3,952 公尺)
- 9.11 和 9.9 哪個大
- strawberry 裡有幾個 r
- 所有貓都是動物、有些動物會游泳,能不能推出有些貓會游泳(不能)
- 用 Python 寫
is_prime(n) - 用繁中條列三點 WireGuard 的優點,每點不超過 15 字(考指令遵循)
模型全部是 w8a8 量化,從 HuggingFace 下載社群轉好的版本:Qwen2.5-1.5B 和 Qwen3-4B-Instruct-2507 來自 GatekeeperZA(v1.2.3 轉),Qwen3.5-2B、Qwen3.5-4B 和 gemma-3-4b-it 來自 HanzoHuang(v1.3.0 轉)。
ℹ️ Qwen3.5 是視覺語言模型的轉檔
HanzoHuang 的 Qwen3.5 repo 是以 VLM 的形式提供,每個平台都有語言模型 .rkllm 和對應的視覺編碼器 .rknn。這次我只下載 .rkllm,用 llm_demo 純文字輸入測試,沒有載入視覺編碼器。純文字對話不需要它;要看圖的話,得改用 multimodal_model_demo 並一起載入 .rknn。
速度與記憶體
| 模型 | runtime | 生成速度 | 記憶體峰值 | 載入時間 |
|---|---|---|---|---|
| Qwen2.5-1.5B | 1.3.0 | 16.2 tok/s | 1.8GB | 1.4 秒 |
| Qwen3.5-2B | 1.3.0 | 8.4 tok/s | 2.2GB | 64 秒 |
| gemma-3-4b-it | 1.3.0 | 4.5 tok/s | 4.5GB | 36 秒 |
| Qwen3.5-4B | 1.3.0 | 3.6 tok/s | 4.7GB | 58 秒 |
| Qwen3-4B-Instruct-2507 | 1.2.3 | 3.7 tok/s | 5.4GB | 約 60 秒 |
Qwen3.5 的載入時間要將近一分鐘,比 Qwen2.5 的 1.4 秒久非常多,拿來做即開即用的服務要考慮進去。
答題結果
| 題目 | Qwen2.5-1.5B | Qwen3.5-2B | gemma-3-4b | Qwen3.5-4B | Qwen3-4B-2507 |
|---|---|---|---|---|---|
| 雞兔同籠 | ✅ | ✅ | ❌ 一直說需要額外資訊 | ✅ | ✅ |
| 玉山 | ✅ | ⚠️ 說是亞洲第一高峰 | ✅ | ⚠️ 說僅次於富士山 | ✅ |
| 9.11 和 9.9 | ✅ | ❌ 說 9.11 大 | ✅(解釋錯) | ⚠️ 答錯後自己更正 | ✅ |
| strawberry | ❌ 說 2 個 | ✅ | ⚠️ 用英文回答 | ✅ | ✅ 標出第 3、8、9 位 |
| 貓會不會游泳 | ❌ 答「能」 | ✅ | ✅ | ✅ 還舉反例 | ✅ 還舉反例 |
| 質數函式 | ✅ | ✅ | ✅ | ✅ | ✅ |
| 字數限制 | ⚠️ | ❌ 超過字數 | ✅ | ✅ 最精簡 | ✅ |
| 得分 | 4.5 | 4.5 | 5 | 6 | 7 |
最讓我意外的是 gemma-3-4b 的雞兔同籠,直接鬼打牆,一直重複「這個問題需要一些額外的資訊才能解決」,還自己假設有 50 隻雞,廢到笑。它的 strawberry 答對了,但突然切成英文回答,也算小扣分。
Qwen3.5-4B 在 9.11 那題很有戲:先斬釘截鐵說 9.11 比較大,講到一半發現不對,自己補了一句「更正:抱歉,剛才的邏輯推導有誤」,改成 9.9。會自我更正是好事,但放在正式產品裡,使用者會先看到錯的答案。
冠軍 Qwen3-4B-Instruct-2507 是唯一連附加資訊都沒講錯的。Qwen 官方模型卡 的數字也支持這個結果:它是 Qwen3-4B 的非思考版更新版,GPQA 從 41.7 拉到 62.0、AIME25 從 19.1 拉到 47.4,進步幅度很誇張。
另外,幾個小模型碰到台灣地理細節都會順手補上錯的資訊,例如「亞洲第一高峰」「僅次於富士山」。需要事實準確的場景,還是要搭配 RAG。
思考模式:答得準,但等不起
Qwen3.5 支援思考模式,我用 4B 開起來重跑一次:
| 題目 | 生成 token | 耗時 | 結果 |
|---|---|---|---|
| 9.11 和 9.9 | 562 | 143 秒 | ✅ 一次答對,不用自我更正 |
| strawberry | 637 | 163 秒 | ✅ |
| 質數函式 | 492 | 133 秒 | ✅ |
| 雞兔同籠、玉山、邏輯、字數限制 | 767 | 168~207 秒 | ❌ 到 768 token 上限還沒答完 |
思考過程全部用英文,每題都要燒 500 到 767 個 token。要讓它每題都答完,max_new_tokens 至少得開到 2048,等於一題要等 5 分鐘以上。答案是比較準,但這個速度拿來聊天就是在哈囉。
為什麼 4B 只有 3.6 tok/s?瓶頸不是 NPU
看到 6 TOPS 的 NPU 跑 4B 模型只有 3.6 tok/s,一開始我也覺得是 NPU 不夠力。其實不是。
LLM 生成文字時,每產生一個 token,就要把整個模型的權重從記憶體讀一遍。The Memory Bandwidth Ladder 這篇講得很白:生成速度的上限大約就是「記憶體頻寬 ÷ 模型大小」,跟 TOPS 關係不大。
那 RK3588 的頻寬有多少?Turing Pi 的 RK1 實測 指出,RK3588 的 64-bit LPDDR4X 理論峰值約 34 GB/s,用 STREAM 實測約 21~22 GB/s。拿我的數字粗估:4B 的 w8a8 權重大約 3.5~4GB,乘上 3.6 tok/s,每秒要搬十幾 GB;1.5B 的權重約 1.3GB,乘上 16 tok/s,也是二十 GB/s 上下。兩個都已經頂到那條天花板了。
更有說服力的是另一個對照:Turing Pi 用 llama.cpp 純 CPU 跑同樣的 RK3588 ,Qwen2.5-1.5B Q4_K_M 有 22.57 tok/s,比我用 NPU 跑 w8a8 的 16.2 還快。原因不是 CPU 比 NPU 強,而是 Q4 量化的模型比 w8a8 小將近一半,每個 token 要搬的資料少。乾,搞半天瓶頸在記憶體。
所以 NPU 在這塊板子上的真正價值,是把 CPU 空出來。NPU 在跑 LLM 時,8 顆 CPU 核心還能做別的事,例如跑 YOLO 的前後處理、網頁服務、Home Assistant。純 CPU 跑 llama.cpp 雖然快一點,但會把 CPU 吃滿。
我的推薦
| 你想做的事 | 選這個 | runtime | 為什麼 |
|---|---|---|---|
| 要最聰明的回答 | Qwen3-4B-Instruct-2507 | v1.2.3 | 7/7,附加資訊也正確 |
| 想用最新架構 | Qwen3.5-4B | v1.3.0 | 6/7,會自我更正 |
| 聊天要順 | Qwen3.5-2B | v1.3.0 | 8.4 tok/s,邏輯題答得對 |
| 簡單問答、要快 | Qwen2.5-1.5B | v1.2.3 | 16 tok/s,載入 1.4 秒 |
| 看圖 | Qwen3.5-0.8B | v1.3.0 | 官方實測影像編碼約 0.69 秒(這次沒測) |
一般人的閱讀速度大約是每秒 5 到 8 個 token,所以 4B 那 3.6 tok/s 拿來即時聊天會覺得有點卡。我會把 4B 用在背景工作,例如文件摘要、訊息分類、Home Assistant 的語音意圖判斷;真的要對話,就用 Qwen3.5-2B。
至於 8GB 放不下的:社群轉的 Gemma4-E2B 檔案有 7.85GB,太冒險;7B、8B 的模型用 w8a8 量化後都超過 8GB。想跑這些,至少要買 16GB 的版本。
Troubleshooting
Q:SSH 連線突然斷掉,板子叫不醒?
多半是桌面映像檔自己休眠了。接上螢幕或按電源叫醒後,執行 sudo systemctl mask sleep.target suspend.target。
Q:llm_demo 的回答寫到一半就結束,而且總是停在逗號?
檢查模型是用哪一版 toolkit 轉的,runtime 要對上。log 的第一行會印出 rkllm-runtime version 和 rkllm-toolkit version。
Q:速度比官方 benchmark 慢三成?
先跑 scripts/fix_freq_rk3588.sh 鎖頻,重開機後要重跑。
Q:板子換網路埠之後拿不到新的 IP?
ROCK 5C 的 rk_gmac-dwmac 驅動偵測不到短暫的拔插,NetworkManager 會繼續用舊 IP。拔線超過 10 秒再插,或在板子上執行 nmcli connection up "Wired connection 1"。
Q:官方的 build-linux.sh 在板子上編不過?
它寫死了 x86 交叉編譯器的路徑。在板子上直接用 cmake -DCMAKE_C_COMPILER=gcc -DCMAKE_CXX_COMPILER=g++ 編譯就好。
結語
折騰一輪下來,我對 RK3588 跑 LLM 的心得是:別被 6 TOPS 騙了,記憶體頻寬才是真正的天花板。 8GB 的板子能跑的最聰明模型大概就是 4B 級,速度 3 到 4 tok/s,拿來做背景的智慧處理很夠用;要聊天,2B 級是比較實際的選擇。
還有最重要的一句:runtime 和模型的轉檔版本要對上。 我這肝差點被那個「逗號就停」的 bug 搞到懷疑人生。
如果你也在 RK3588 上跑過 LLM,歡迎在下面留言分享你的模型和速度。我下一步想試 rkllm_server_demo,把它包成 API 接進 Home Assistant,做一個完全離線的語音助理,有興趣的可以追蹤一下。
參考資料
- Radxa RKLLM 安裝文件
- Radxa YOLOv8 部署文件
- Radxa RKNN 安裝文件
- Radxa ROCK 5C 產品介紹
- CNX Software:ROCK 5C 規格整理
- airockchip/rknn-llm Releases
- RKLLM v1.3.0 官方 benchmark
- rknn_model_zoo issue #454:RK3588 YOLOv8n/YOLO11 實測
- Turing Pi:RK1 Benchmarks(記憶體頻寬)
- Turing Pi:RK3588 LLM GGUF 量化比較
- The Memory Bandwidth Ladder
- Qwen3-4B-Instruct-2507 官方模型卡


