顯示具有 AI 工具 標籤的文章。 顯示所有文章

Claude Code 動態工作流程實戰:一個對話塞不下時,就讓上千個 subagent 一起上

環境與前置條件
- Claude Code v2.1.154 以上(claude --version 先確認)
- 付費方案(Pro / Max / Team / Enterprise)或 API / Amazon Bedrock / Google Vertex AI / Microsoft Foundry
- Pro 方案要先到 /config 把「Dynamic workflows」那一列打開
- 功能狀態:research preview(2026-05-28 隨 Claude Opus 4.8 一起發布),行為可能還會變
- 預設知識:你已經用過 Claude Code、知道 subagent 跟 slash command 大概是什麼

我第一次認真用 /deep-research 是想查一個 Node.js 權限模型的版本差異。我按下 Enter,然後——畫面沒有一行一行慢慢吐字,而是冒出一個背景任務面板,裡面有十幾個 agent 各自跑去搜不同角度、互相打架、把站不住腳的論點砍掉,最後丟回一份標好引用的報告。我那條對話從頭到尾還是空的、隨時能繼續打字。

那一刻我才意識到,Claude Code 的玩法被改寫了。過去 subagent 是「Claude 一輪一輪決定要派誰」,現在 Dynamic Workflows(動態工作流程) 把整個編排計畫搬進一段 JavaScript 腳本,由一個獨立 runtime 在背景跑,規模直接拉到單次最多 1,000 個 subagent。這次更新(細節見 The New Stack 的報導 )給我的整體感覺就一句話:過去那種「一次小心翼翼的單一 pass」,不再是預設玩法了。

這篇文章我會把它從頭講到尾——它到底是什麼、怎麼觸發、腳本長怎樣、pipeline 跟 parallel 到底差在哪(這裡超多人寫錯),還有那些一不小心就會燒掉一堆 token 的雷。

中央編排節點向外輻射出大量 subagent 節點的示意圖

Workflow 到底是什麼?跟 subagent、skill 差在哪

先把名詞釐清,不然後面會一直打結。Claude Code 裡能跑「多步驟任務」的東西其實有三種:subagent、skill、workflow。它們最核心的差別,官方文件 講得很精準——差在「誰持有那個計畫(who holds the plan)」。

Subagents Skills Workflows
本質 Claude 生出來的 worker Claude 遵循的一組指示 runtime 執行的腳本
誰決定下一步 Claude,一輪一輪 Claude,照著 prompt 腳本本身
中間結果放哪 Claude 的 context Claude 的 context 腳本變數
可重複的是什麼 worker 定義 那組指示 編排邏輯本身
規模 每輪幾個 同 subagent 每次 run 數十到數百個 agent
中斷怎麼辦 重跑那一輪 重跑那一輪 同 session 內可 resume

用 subagent 跟 skill 的時候,Claude 自己是那個指揮官:它一輪一輪決定接下來生什麼,而且每個結果都會掉回它的 context 裡。問題是 context 是有限的,當你要掃 300 個檔案、每個都吐一份報告回來,Claude 的腦袋很快就塞爆了,夭壽。

Workflow 的解法是把那個指揮計畫——迴圈、分支、中間結果——全部寫進程式碼。腳本自己持有狀態,Claude 的 context 最後只拿到一份濃縮過的答案。這不只是「能跑更多 agent」而已,它還讓你能套用可重複的品質模式:讓幾個獨立 agent 互相對抗審查彼此的發現、或從好幾個角度各自起草一份方案再拿來比,最後得到的結果比單次 pass 可信得多。

一句話記法,幫你以後不會選錯工具:

一兩個獨立調查     → 用 subagent
know-how 要重用    → 用 skill
編排本身要重複     → 用 workflow(fan out、比較發現、重啟失敗的 agent、存起來當命令)

workflow 與 subagent 編排架構對比流程圖

到底有多大規模?開發者社群流傳過一個會嚇到的個案:有人用動態工作流程把 Bun 從 Zig 移植到 Rust,據說原測試套件 99.8% 通過、約 75 萬行 Rust、十一天就 merge。這類數字我沒辦法逐一查證、純粹當茶餘飯後看,但那個量級感受得到。比較踏實、官方自己列出來的標準場景是:全庫 bug sweep、500 個檔案的大遷移、需要跨來源交叉驗證的研究、以及「值得從好幾個角度各自起草再擇一」的困難計畫。

三種觸發方式:關鍵字、deep-research、ultracode

要讓 Claude 幫你寫並跑一個 workflow,總共三條路。

第一條:prompt 裡丟 workflow 這個字。 最直接,單次觸發、不改 session 的設定。

Run a workflow to audit every API endpoint under src/routes/ for missing auth checks

Claude Code 會把那個字反白,然後改成「幫你寫一段 workflow 腳本」而不是一輪一輪手動做。如果你只是剛好打到 workflow 這個字、根本沒想觸發,按 alt+w 就能忽略這一輪。

第二條:內建的 /deep-research。 這是目前唯一的 bundled workflow,也是最好的入門體驗:

/deep-research What changed in the Node.js permission model between v20 and v22?

它會對問題從好幾個角度 fan out 網路搜尋、抓回來源互相 cross-check、對每個論點投票,最後給你一份引用完整、而且已經把站不住腳的論點濾掉的報告。

第三條:ultracode 模式。 這是把油門踩到底的玩法:

/effort ultracode

Ultracode = xhigh 推理強度 + 自動 workflow 編排。開了之後,Claude 每個實質任務都會自己判斷要不要編成 workflow,一個請求甚至會拆成好幾個連續的 workflow(一個負責理解程式碼、一個負責改、一個負責驗證)。代價就是每個任務都更燒 token、更慢,而且只在當前 session 有效,回到例行工作記得用 /effort high 降回來,不然帳單會讓你傻眼。

順帶一提,啟動時會不會跳權限確認,取決於你的 permission mode:Default / acceptEdits 每次都問(除非你選過「不再詢問這個 workflow」);Auto 只問第一次;Bypass、claude -p、Agent SDK 則直接開跑不問。有個細節很重要——workflow 生出來的 subagent 一律以 acceptEdits 模式跑、檔案編輯自動核准,但不在你 allowlist 裡的 shell / web / MCP 工具還是會在執行中跳提示。所以長 run 之前,先把 agent 會用到的指令加進 allowlist,不然跑到一半被一個權限框卡住,超雷。

腳本長怎樣:meta 加五個 API(順便校正坊間的簽名錯誤)

這一段是整篇的重點。我看過好幾篇教學把 API 簽名寫錯,照著抄一定跑不起來,所以這裡用 Claude Code 實際工具規格來校正。

先講清楚:官方那份 workflows 文件 主要描述「使用者怎麼操作」(觸發、權限、resume、成本),腳本層的 API 細節(agent / parallel / pipeline / budget / 程式化 resume 等)目前較少公開。下面這些簽名取自 Claude Code 的 workflow 執行環境(也就是 Claude 寫腳本時實際看到的規格),會隨版本演進——照抄前請以你自己 Claude Code 版本的實際行為為準。

每個 workflow 腳本必須以 export const meta = {...} 開頭,而且 meta 必須是純字面量——不能用變數、函式呼叫、展開運算子或樣板字串插值,runtime 會在你還沒跑之前就要讀它:

export const meta = {
  name: 'review-changes',                              // 必填
  description: 'Review changed files and verify findings', // 必填,權限對話會顯示這句
  whenToUse: 'after a large diff',                     // 選填,列在 workflow 清單裡
  phases: [                                            // 選填但建議,每個 phase() 對應一筆
    { title: 'Review' },
    { title: 'Verify' },
  ],
}

// 腳本本體從這裡開始,是 async context,可以直接 await
phase('Review')
const result = await agent('review src/auth.ts for bugs', { schema: FINDINGS_SCHEMA })

接著是五個核心 API,請務必看清楚參數型別:

API 簽名 重點
agent agent(prompt, opts?) 啟一個 subagent。沒給 schema 回傳純文字字串;給了 schema 回傳驗證過的物件。opts 有 label、phase、schema、model、isolation:'worktree'、agentType。使用者中途略過會回傳 null。
pipeline pipeline(items, stage1, stage2, ...) 每個 item 獨立流過所有 stage,stage 之間沒有 barrier。stage callback 收到 (prevResult, originalItem, index)。某個 item 在某 stage 拋錯就變 null、跳過後續。
parallel parallel(thunks) thunks 是函式陣列 Array<() => Promise<any>>,不是直接傳 agent。這是個 barrier,等全部完成才回傳。某個 thunk 拋錯那一格變 null(呼叫本身不會 reject),用之前先 .filter(Boolean)。
phase phase(title) 開一個新階段,之後的 agent() 在進度面板會歸到這個標題下。
log log(message) 對使用者吐一行進度訊息。

最容易寫錯的就是 parallel。 我看過不少文章寫成 parallel(agent(...), agent(...)),直接把 agent 的回傳值丟進去——這樣等於在呼叫 parallel 之前就已經把 agent 啟動了,整個並行的意義就沒了。正確寫法是傳還沒被呼叫的函式(thunk):

// ❌ 錯:直接傳 agent 的結果(簽名也錯)
const r = await parallel(agent('check a'), agent('check b'))

// ✅ 對:傳一個函式陣列,每個函式回傳一個 Promise
const r = await parallel([
  () => agent('check a'),
  () => agent('check b'),
])
const usable = r.filter(Boolean)  // 拋錯的會是 null,先濾掉

還有一個我大力推薦的東西:schema 結構化輸出。給 agent() 傳一個 JSON Schema,subagent 會被強制呼叫 StructuredOutput 工具回傳已驗證的物件,不符合還會自動重試。從此不用自己解析一坨文字、不用祈禱它格式對:

const FINDINGS = {
  type: 'object',
  properties: {
    findings: {
      type: 'array',
      items: {
        type: 'object',
        properties: {
          title:    { type: 'string' },
          file:     { type: 'string' },
          severity: { type: 'string' },
        },
        required: ['title', 'file'],
      },
    },
  },
  required: ['findings'],
}

const r = await agent('find bugs in src/auth.ts', { schema: FINDINGS })
// r.findings 直接是陣列,拿了就用

最後幾個會踩到的環境限制,先講免得你撞牆:

  • 腳本是純 JavaScript,不是 TypeScript。型別註記 : string[]、interface、generics 一律解析失敗。
  • Date.now()、Math.random()、無參數的 new Date() 會直接丟錯(因為它們會破壞 resume 機制)。要時間戳就從 args 傳進去,要亂數就靠 index 去變化 prompt。
  • 腳本本身沒有檔案系統跟 shell 存取權。讀檔、寫檔、跑指令都是 agent 在做,腳本只負責調度。

左側同步並行撞上 barrier、右側獨立交錯流動的資料流對比圖

pipeline 還是 parallel?這是最常踩的雷

這題我特別拉一段出來講,因為選錯的代價是白白浪費牆鐘時間。

原則一句話:預設用 pipeline,只有當「下一階段真的需要上一階段的全部結果」時才用 parallel 的 barrier。

pipeline 沒有 barrier。item A 可以已經在第三 stage,同時 item B 還卡在第一 stage。整段的牆鐘時間 = 最慢的那一條單一 item 的鏈,而不是「每個階段最慢的那個」加總。這個差異在 agent 速度落差大的時候非常明顯:

const DIMENSIONS = [
  { key: 'bugs', prompt: 'review for correctness bugs' },
  { key: 'perf', prompt: 'review for performance issues' },
]

const results = await pipeline(
  DIMENSIONS,
  // stage 1:審查
  d => agent(d.prompt, { label: `review:${d.key}`, phase: 'Review', schema: FINDINGS }),
  // stage 2:每個發現派人對抗驗證(不用等別的維度審完)
  review => parallel(
    review.findings.map(f => () =>
      agent(`Adversarially verify: ${f.title}`, { phase: 'Verify', schema: VERDICT })
        .then(v => ({ ...f, verdict: v }))
    )
  ),
)
// 'bugs' 的發現在驗證的同時,'perf' 還在審——牆鐘時間不浪費

那什麼時候才真的該用 parallel 的 barrier?只有這幾種:下一階段要拿到全集合才能動——例如在昂貴的下游工作前先去重 / 合併全部結果、或是要提早退出(「0 個 bug 就整段跳過驗證」)、或是下一階段的 prompt 要「跟其他所有發現比較」。

// barrier 真正合理的場景:去重後才驗證
const all = await parallel(DIMENSIONS.map(d => () => agent(d.prompt, { schema: FINDINGS })))
const deduped = dedupe(all.filter(Boolean).flatMap(r => r.findings))  // 真的需要全集合
const verified = await parallel(deduped.map(f => () => agent(verifyPrompt(f), { schema: VERDICT })))

有個嗅探測試很好用:如果你寫出來的是「parallel → 一段純資料轉換(flatten / map / filter,沒有跨 item 依賴)→ parallel」,那中間那個 barrier 根本不需要,把轉換塞進 pipeline 的 stage 裡就好。猶豫的時候,選 pipeline 準沒錯。

進階品質模式:讓 agent 互相打臉

Workflow 真正比「叫一個 agent 做事」強的地方,是它能套用結構化的品質模式。這也是 Anthropic 官方部落格 一直強調的賣點。

對抗驗證(Adversarial Verify) 是其中最實用的。發現一個問題後,不是直接信它,而是派 N 個獨立的懷疑者、prompt 明確要他們反駁,多數反駁就否決。據 MarkTechPost 的報導 ,這個「其他 agent 專門去反駁前面發現」的機制是內建在 run 裡的,只有撐過反駁的論點才會送到你面前。舉個我自己常遇到的情境:當一個 subagent 宣稱某函式有 race condition,你就讓另一個 subagent 的唯一任務是想辦法推翻它——推不翻,這個 bug 才算數。

const votes = await parallel(
  Array.from({ length: 3 }, () => () =>
    agent(`Try to refute this claim: ${claim}. Default to refuted=true if uncertain.`,
          { schema: VERDICT }))
)
const survives = votes.filter(Boolean).filter(v => !v.refuted).length >= 2

兩個霓虹綠 agent 對峙、綠色箭頭互相碰撞如辯論的示意圖

Judge panel(法官小組) 適合解空間很寬的問題:從不同角度(MVP 優先、風險優先、使用者優先)各生一份獨立方案,並行 judge 評分,最後從贏家綜合、再把亞軍的好點子嫁接進來。比「單一方案反覆迭代」常常好得多。

Loop-until-dry(跑到枯竭) 用在未知規模的發現任務(bug、edge case):持續派 finder 直到連續 K 輪沒有新東西。這裡有個經典的坑——去重要對著 seen 集合,不是對著 confirmed,否則被否決掉的發現每一輪都會重新冒出來,永遠收斂不了:

const seen = new Set(), confirmed = []
let dry = 0
while (dry < 2) {                                  // 連續兩輪沒新東西才停
  const found = (await parallel(FINDERS.map(f => () =>
    agent(f.prompt, { phase: 'Find', schema: BUGS })))).filter(Boolean).flatMap(r => r.bugs)
  const fresh = found.filter(b => !seen.has(key(b)))
  if (!fresh.length) { dry++; continue }
  dry = 0
  fresh.forEach(b => seen.add(key(b)))             // 對 seen 去重,不是 confirmed
  // ……對 fresh 做多 lens 評審後,把通過的 push 進 confirmed
}

還有 multi-modal sweep(多個 agent 各用不同方式搜:by-container、by-content、by-entity、by-time,補單一角度的盲區)跟 completeness critic(最後派一個 agent 專門問「漏了什麼?哪個模態沒跑、哪個論點沒驗證」)。這些模式可以自由組合,不是互斥的。

並發、budget、resume:跑大 run 之前要懂的事

規模拉大之後,有三件事一定要搞清楚,不然不是燒錢就是白做。

並發上限。 官方文件講的是「最多 16 個並行 agent,CPU 核心少的機器會更少」(確切公式官方沒講明,大致隨可用核心數遞減),超過的會排隊等空位。單次 run 的總量上限是 1,000 個 agent——這是防失控迴圈的後盾,遠高於正常用量。你還是可以丟 100 個 item 給 parallel / pipeline,它們全部都會完成,只是同一時間大概只有十個左右在跑。

Token budget。 一次 workflow run 可能比用對話做同一件事燒多很多 token,而且照樣計入你方案的用量跟速率限制。每個 agent 預設用你 session 的模型,除非腳本用 opts.model 把某個 stage 導去別的模型。所以大 run 之前先 /model 確認一下、把不需要最強腦的 stage 換成小模型。腳本裡還有個 budget 物件可以拿來動態縮放深度:

const bugs = []
while (budget.total && budget.remaining() > 50_000) {
  const r = await agent('Find bugs in this codebase.', { schema: BUGS })
  bugs.push(...r.bugs)
  log(`${bugs.length} found, ${Math.round(budget.remaining() / 1000)}k remaining`)
}

注意那個 budget.total && 的 guard 不能省——沒設預算時 remaining() 會回 Infinity,這個迴圈會一路跑到 1,000 agent 上限才停,爆肝燒錢就是這樣來的。

Resume(暫停與恢復)。 在 /workflows 裡選中一個 run 按 p 就能暫停 / 恢復,已完成的 agent 會回傳快取結果、其餘的繼續跑。據 digitalapplied 的整理 ,workflow 可以從先前的 runId 恢復,所以你改了腳本之後,沒被動到的 agent 不會重跑——最長未變動的呼叫前綴會秒回快取,從第一個被改或新增的呼叫起才實跑。對應的程式化重跑形式(帶 scriptPath 與 resumeFromRunId)屬於前面提過的腳本層 API,官方公開文件還沒完整載明,以你的版本實際行為為準。

但有一個硬限制要記住:resume 只在同一個 Claude Code session 內有效。你只要退出 Claude Code,下次啟動時 workflow 就從頭來過。所以多日的大工程,盡量別關。

霓虹綠進度環與暫停/恢復控制、周圍漂浮快取資料塊的示意圖

最佳實踐與踩坑清單

把前面散落的雷集中起來,這張表存著,下次寫 workflow 前掃一遍:

你做的事 後果 正確做法
parallel(agent(), agent()) 簽名錯、根本沒並行 parallel 收函式陣列 [() => agent(...)]
動不動就用 barrier 快的 agent 空等慢的,浪費牆鐘 預設 pipeline,barrier 要有正當理由
loop 去重對 confirmed 被否決的發現每輪重現,永不收斂 對 seen 去重
budget 迴圈沒 guard budget.total 沒設預算時 Infinity,跑到 1,000 上限 while (budget.total && remaining() > X)
腳本裡用 Date.now() / Math.random() 直接丟錯、破壞 resume 時間從 args 傳、亂數靠 index
期待 subagent 自己整合彼此的工作 重複跟衝突一堆 整合交給最後的綜合階段或你自己
退出 session 後想 resume 從頭跑、白燒一輪 resume 僅限同 session;或用 scriptPath + resumeFromRunId
沒設明確終止條件的迴圈 逼近 1,000 agent 上限 設品質閾值或 dry-count 退出

幾個正面的習慣也一起列:任務邊界要講清楚(「audit src/routes/ 每個 endpoint 缺漏的 auth check,附 severity」遠勝於「improve the codebase」);用 schema 拿結構化輸出免解析;subagent 任務要可獨立驗證、輸入輸出明確、只碰有界的檔案集;規模化之前先小跑(/deep-research 或先掃 5~10 個檔)確認成本;成功的 run 記得在 /workflows 裡按 s 存成 /<name> 命令重複用——專案級存 .claude/workflows/(可進 git、整隊共用),個人級存 ~/.claude/workflows/。

至於底層模型,這次 Claude Opus 4.8 的數字 也撐得起這套玩法——據報導 SWE-bench Pro 拿到 69.2%、長上下文檢索(GraphWalks long-context F1,1M tokens)達 68.1%,誠實度也明顯提升(官方主打未回報的程式碼瑕疵大幅減少)。對於要派上百個 agent 互相審查的場景來說,底層模型誠不誠實、看不看得懂長 context,直接決定了最後那份報告能不能信。

什麼時候該用、什麼時候別用

最後給個明確的判斷,免得你拿大砲打蚊子。

該用 workflow 的場景:全庫 bug sweep 或安全審計(100+ 檔)、大規模遷移(500+ 檔)、需要多來源交叉驗證的研究、值得從多角度起草再擇一的困難計畫。據 explainx.ai 的整理 ,這類「過去要一季、現在幾天」的大工程正是它的主場。

別用的場景:單檔編輯、快速 bug 修復、簡單問答——這些用對話或一兩個 subagent 就好,動 workflow 純粹是浪費 token。know-how 想重用就寫成 skill。token 預算緊張的時候也先忍著。

說穿了,動態工作流程不是要取代你跟 Claude 的對話,而是給你一個「當任務大到一個 context 裝不下」時的逃生艙。先從 /deep-research 玩起,習慣那個背景任務面板的節奏,再試著在 prompt 裡丟一個 workflow 讓 Claude 幫你寫第一支腳本。跑順了、覺得這流程每條 branch 都會重複,就按 s 存起來——下次它就是你自己的 / 命令了。

要不要現在就開一個小的試?挑你手邊一個「想掃但一直懶得掃」的資料夾,丟一句 Run a workflow to ...,看看十幾個 agent 同時上工是什麼感覺。跑完不妨在留言區分享你燒了多少 token、值不值得。


參考資料

Codex vs Claude Code:用了大半年,我把這兩個 AI coding agent 的「個性」摸透了

兩個 AI coding agent 在賽博機房裡對峙,一藍一綠

有件事我一直覺得很妙。

某次我把 Claude Code 寫好、自己看過覺得沒問題的一段程式碼,丟給 Codex 做 review。結果 Codex 一口氣抓出一堆我跟 Claude 都沒注意到的問題——race condition、漏掉的 edge case、一個會在高併發下爆掉的鎖。我心想好吧那反過來呢?把 Codex 寫的程式碼丟給 Claude Code 看。Claude 看了半天,給我一句客客氣氣的「這段寫得很完整,沒有發現明顯問題」。

這個不對稱的現象,在 Hacker News 的討論串 跟一堆 Reddit 貼文裡反覆出現,不是只有我遇到。它其實濃縮了一件事:Codex 跟 Claude Code 不是「誰比較強」的問題,而是它們根本是兩種不同性格的生物。 你拿 benchmark 分數去比,會發現兩邊幾乎打平;但真正決定你每天用起來爽不爽的,是它們的「脾氣」。

這篇就來聊聊我用了大半年下來,對這兩個工具最真實的使用體感——不是比規格表,是比那種「跟它共事久了才會懂」的細節。


它們根本不是同一種生物

先把最容易搞混的東西講清楚。雖然大家都叫它們「終端 AI coding agent」,但這兩個工具從骨子裡的設計哲學就分岔了。

Claude Code 是 Anthropic 的終端原生工具 ,預設跑在你自己的機器上,邊做邊跟你報告每一步、動到危險的東西會先問你。它的整個互動模型是「developer-in-the-loop」——你跟它並肩坐著,隨時可以打斷、可以導正。

Codex 則是 OpenAI 從雲端優先(cloud-first)出發 設計的,預設把任務丟進一個隔離的雲端 sandbox 裡跑。它的模型是「委派」——你描述任務、走開、回來看結果(通常是一個 PR)。它在 macOS app、CLI、IDE 擴充、ChatGPT 網頁、甚至 Slack 裡 @Codex 都能用。

左邊本地終端發綠光,右邊雲端 sandbox 容器發藍光,光束相連

把規格攤開來看會更清楚:

維度Claude CodeCodex
主力模型(2026-05)Opus 4.7、Sonnet 4.6GPT-5.4、GPT-5.5、GPT-5.3-Codex
預設執行環境本地終端(你的機器)雲端 sandbox + 本地 CLI
互動風格逐步敘述、要你批准丟出去自己跑、回來看 PR
開源否是(Apache 2.0、Rust binary)
沙箱安全應用層(26 種可程式化 hook)OS kernel 層(Seatbelt / Landlock / seccomp)
設定檔CLAUDE.md(專有)AGENTS.md(開放標準)
Context window1M tokens(Max/Team 標準定價)272–400K,GPT-5.4 實驗性 1.05M

這張表你不用背,只要記住一句話:Claude Code 從「本地、敘述、要你批准」長出來,Codex 從「雲端、自主、給你成品」長出來。 後面所有體感差異,都是從這個分岔點延伸出來的。

順帶一提,Codex 的桌面 app 在 2026 年 2 月推出時是 macOS only ,Windows/Linux 用戶當時只能用 CLI——這對一些跨平台團隊來說是個 dealbreaker,要留意。


真正的差異,是它們的「個性」

規格表看完你大概無感,因為兩邊看起來都很能打。但用久了你會發現,最有感的差異 benchmark 永遠測不出來——是它們的講話方式跟做事節奏。

onevcat 那篇用了一個半月的深度心得 把這件事講得超精準,跟我的體感幾乎一模一樣:

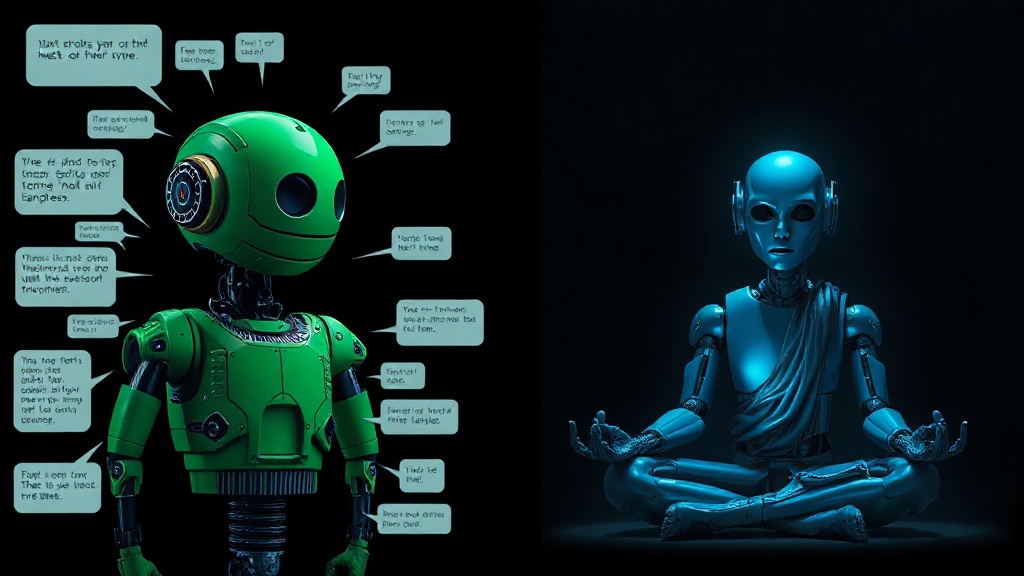
Claude 相對啰嗦但細緻。 它喜歡把每個決策的前因後果、自己正在做什麼,都解釋給你聽,偶爾還會附贈一句「You're absolutely right」的情緒價值。這種個性在「理解專案、做簡單測試、邊探索邊調整」的時候超好用——你看得到它在想什麼,走錯方向馬上喊停。但處理困難任務時,它有時會顯得效率不高,而且很容易被你帶偏:你一句「會不會是這裡的問題?」它可能就真的順著你那個錯誤方向一路跑下去。

Codex 則是人狠話不多,直達要害。 它幾乎不解釋為什麼這麼做,往往就自己悶頭苦幹個十來分鐘,然後直接甩給你一個簡潔有效的解法。onevcat 那個比喻我超愛——「就彷彿在跟一個掃地僧對話,一個眼神勝過千言萬語」。但這種含蓄也有代價:碰到架構設計或需要研究的任務,除非你明確要求它解釋,否則那種「沉默是金」會讓你完全摸不透它的思路。

左邊話多的綠機器人被一堆對話框包圍,右邊像掃地僧一樣安靜的藍機器人

這裡有個很多人會踩的坑:話多不等於比較好。 我以前也以為 Claude 解釋得多就是比較聰明,後來才想通——這只是「適不適合當下這個任務」的問題。需要對齊需求、邊做邊釐清的活,Claude 的啰嗦是優點;目標明確、規格寫死的活,Codex 的沉默高效反而更省心。

還有一個實務上的雷:Codex 很常用 Python 腳本去改檔案,產出的 diff 不是那種一行一行清楚的修改,而是一坨腳本執行結果,review 起來很痛苦 。所以你基本上只能等它跑完、看最後結果,沒辦法像 Claude 那樣盯著過程即時介入。這也是為什麼——

Claude Code 適合 pair programming,Codex 不適合。 Claude 那種快速迭代、approve 每個 edit、走偏就打斷的節奏,就是結對編程的精髓。Codex 太慢了,它的正確用法是「丟出去,十分鐘後回來收貨」。HN 上一個資深開發者的配比我覺得很有代表性:Claude Code 用 80%、Codex 用 20%,但 Codex 當 PR reviewer 是所有工具裡最強的。


Benchmark?早就打平了

如果你還在用 SWE-bench 分數來決定要用哪個,我勸你省點力。2026 上半年這兩邊的數字已經咬得超緊,而且每次有新模型就翻盤一次。

Benchmark(2026 上半年)Codex(GPT-5.x)Claude Code(Opus 4.x)
SWE-bench VerifiedGPT-5.5 88.7%(5 月反超)Opus 4.7 87.6%
Terminal-Bench 2.0GPT-5.3-Codex 77.3%Opus 4.7 69.4%
OSWorld-Verified(電腦操作)較低72.7%(領先)
Token 效率省 2–4×吃 token 較凶

SWE-bench Verified 上,GPT-5.5 在 5 月以 88.7% 微幅反超了 Opus 4.7 的 87.6% ——差距只有 1.1 分,根本是測量誤差等級。但你換個 benchmark 結論就變:Terminal-Bench 2.0 上 Codex 把 Claude 拉開一截(GPT-5.3-Codex 77.3%、GPT-5.4 75.1% vs Opus 4.7 69.4%,不同評測機構數字略有出入),終端/debug 類任務它是真的強。

所以與其問「誰分數高」,不如問「它們各自擅長哪條軸線」。這個結論反而很穩定:

  • Codex 擅長:terminal 操作、debug、抓 race condition 跟 edge case、PR review。Composio 的實測 裡,Codex 持續抓出 Claude 漏掉的邏輯錯誤。
  • Claude 擅長:大型 codebase 推理、跨檔重構、前端設計保真。同一份 Figma 設計克隆測試 裡,Claude 保留了排版結構跟原始設計的圖片,Codex 給的版本功能正常但視覺有出入。

一個我覺得最該記住的數字是 token 效率:Codex 完成同樣的任務通常省得多,各家評測落在 2–3 倍 到 約 4 倍 之間,依任務型態而定。這件事看起來不起眼,但它直接連到下一個——也是會真正讓你崩潰的——問題。


會讓你崩潰的,其實是額度

能量油表快見底、亮起紅色警示燈

講真的,benchmark、個性那些都還好,rate limit 才是會讓你當場想砸鍵盤的東西。 這也是 Reddit 上最高頻、而且方向超一致的抱怨。

Claude Code 這邊,Opus 吃 token 的速度快到誇張。5 小時額度、每週額度動不動就撞牆,一堆重度用戶被迫只能拿 Claude Code 來「規劃」 ,或是中途降級去用 Sonnet 才不會超限。onevcat 甚至算過,他以 API 計價的方式,一個半月燒掉了價值三千多美金的 token——後來 Anthropic 推出 weekly limit,他自嘲「大概就是針對我這種重度用戶吧」。

Codex 這邊就寬鬆很多。同樣 $20 的 Plus 方案,一個 Reddit 用戶說他「狂刷 GPT-5.4 xhigh 都還碰不到 5 小時限制」 ,auto-compact 也很平順、長 session 不太掉 context。這就是大量人從 Claude Code 跳去 Codex 的頭號原因——不是模型比較強,是同樣的錢能做更多事。前面講的 token 效率 2–4×,到這裡就直接兌現成「更不容易撞額度」。

不過這裡要踩個煞車,講兩個反面訊號,免得你以為 Codex 是萬靈丹:

第一,Codex 也有週期性「變笨」的抱怨 。每隔一陣子就會冒出一波「Codex 失去魔力了」「最近在複雜問題上越來越笨、自主性下降」的貼文,通常是 OpenAI 默默調整模型導致的。這種事 Claude 也會發生,兩邊都不能免疫。

第二,Codex 雖然額度寬鬆,但它很 verbose,話多會吃掉額度優勢。有用戶就吐槽「Codex 很囉嗦,考慮到它的 limit 這點滿煩的」。所以省不省,還是要看你的任務型態。


我的混合工作流(也是業界主流)

繞了一圈,結論其實很無聊但很實在:能同時用就同時用。 這不是和稀泥,是 2026 年絕大多數資深開發者收斂出來的共識。它們的強項剛好互補,硬要二選一反而虧。

綠機器人畫架構藍圖、藍機器人拿放大鏡檢查程式碼,協作工作流

我自己是做硬體/韌體的,BLE、儀器、各種工具鏈一大堆,分享一下我的配法:

工作流程: 需求/任務 → 判斷類型 →(規劃/重構/理解 codebase)走 Claude Code 主力;(規格明確/可無人值守)丟 Codex 外包執行 → 兩者寫完、commit 前 → 交給 Codex 當 PR reviewer → 合併。

拆開講:

Claude Code 當主力,負責規劃、跨檔重構、理解既有 codebase、以及那些需要邊做邊對齊的活。對我來說最關鍵的是——它的 MCP 生態超成熟 ,我那一堆串接硬體、BLE 抓包、邏輯分析儀的 MCP server 接上去就能用,這是 Claude Code 的主場。

Codex 當 reviewer 兼執行外包。寫完、commit 之前,固定丟給 Codex 做一輪 PR review(前面說過,它是公認最強的 reviewer)。另外那些規格寫死、可以無人值守的任務——批次腳本、CI、DevOps、純粹的 debug——直接丟給它在雲端 sandbox 跑,我去做別的事。

還有個進階玩法:兩者都能當對方的 MCP server,互相呼叫。不少 power user 就靠這個做自動化的交叉 code review,讓 Claude 寫的東西自動過一遍 Codex 的法眼。

如果你真的預算有限只能挑一個,我的建議是:

  • 主要做韌體 debug、terminal 操作、規格清楚的活,而且很在意每月帳單 → 選 Codex。
  • 主要做大型重構、需要深度推理跟互動、重度依賴 MCP 工具鏈,或公司幫你出錢 → 選 Claude Code(搭 Max 方案解額度焦慮)。

最後,講點掃興的真話

用了這麼久,我反而對「選哪個工具」這件事越來越無所謂了。

onevcat 那句話 我很認同:「當代 LLM 用戶的忠誠度接近於零,新模型吊打舊模型是業界常態,於是用戶也像候鳥一樣來回遷移。」廠商想用應用層那些 commands、subagent 配置來綁住你,但說真的——換工具的時候,那些精心設計的設定檔,幾分鐘複製貼上就能在新工具上重建。真正留得住人的,從來不是 lock-in,是模型本身的能力跟性價比。

所以與其糾結「Codex 還是 Claude Code」,不如把力氣花在一個更值得練的技能上:把需求講清楚。模糊的需求產生模糊的程式碼,清晰的需求才能逼出高品質的輸出。這個能力不管你用哪個工具、不管明年又冒出什麼新模型,都不會過期。

工具會一直換,候鳥年年遷徙。你的判斷力跟表達力,才是那個不會被 deprecated 的東西。

你現在主力是哪一個?有沒有什麼任務是某一邊特別頂、另一邊怎麼調都不行的?歡迎留言聊聊你的配方,我很想知道別人都怎麼搭。


參考資料

延伸閱讀

ChatGPT使用技巧全指南(2025年5月最新)

本文將全面介紹ChatGPT Plus的各種模型功能與實用技巧,讓您從訂閱中獲得最大價值。

2025年5月最新更新!包含o3和o4-mini等最新模型詳解

很多使用者每個月花費20美元訂閱了ChatGPT Plus版本,卻沒有充分利用訂閱提供的多樣化AI模型功能。其實,在ChatGPT Plus中包含了多達八款功能強大的AI模型,每個模型都有各自的特長,從圖像分析、計劃任務到快速回應,都能滿足不同的使用需求。

ChatGPT模型架構:兩大系統的全新定位(2025年5月最新)

隨著AI技術迅速發展,OpenAI已經將ChatGPT模型明確劃分為兩大系列,設計宗旨和功能特長各異:

  1. GPT系列:屬於「通用型模型」,強調回應速度、多模態處理和即時互動,適合日常對話、內容創作和一般應用。
  2. o系列:屬於「推理模型」,專為複雜推理、深度分析和專業領域設計,適合解決需要多步驟邏輯思考的專業問題。

ChatGPT最新模型詳解(2025年5月更新)

GPT系列模型

GPT-4o(2024年5月13日推出)

  • 全能型多模態旗艦模型,能夠處理文字、語音、圖像和影片
  • 支援即時互動、圖像分析和生成高品質圖片
  • 能從影片中截取畫面進行分析,適合處理多媒體內容
  • 已開放給所有用戶使用(免費、Plus、Pro、Team和Enterprise)
  • 適用場景:旅遊規劃、數學教學、商品推薦、日常創意內容生成

GPT-4o mini(2024年7月18日推出)

  • GPT-4o的輕量版,速度更快、成本更低
  • 適合日常快速問答和小型圖像分析任務
  • 從2025年1月起免費可用
  • 不擅長複雜規劃任務或高精度圖片生成
  • 適用場景:日常使用、簡單圖像分析、高頻率互動

GPT-4.5(2025年2月27日推出)

  • 專業情感多模態版,OpenAI最新研究預覽模型
  • 特點:更高情商、更強知識準確性、創意生成、低幻覺率
  • 在語言理解、情感互動和專業推理上表現優秀
  • 目前僅限Plus和Pro用戶使用,且有使用次數限制
  • 適用場景:創意構想、品牌行銷策略、主觀性規劃任務、商業文案、小說或學術論文

GPT-4.1(2025年4月14日推出)

  • 超長上下文處理的專業API模型
  • 具備超長上下文處理能力和卓越的資訊整合性能
  • 目前僅透過API供開發者使用,尚未整合進ChatGPT網頁版
  • 適用場景:商業分析報告、學術研究、策略建議、多輪對話串接的應用開發

o系列模型

o3(2025年4月17日更新)

  • OpenAI推出的最高階推理模型
  • 特色:強大的邏輯推理能力,能"用圖像思考",使用Python來處理圖片
  • 整合了ChatGPT內建工具,可以即時搜尋網路資料、使用Python做分析或繪圖、解讀與生成圖片
  • 思考時間較長,但提供詳盡資訊
  • 適用場景:學術研究、工程技術、技術文件撰寫、程式設計、邏輯分析等專業任務

o4-mini(2025年4月17日推出)

  • 高效率推理模型,o3-mini的進化版
  • 特色:快速進行高級推理、成本低、效率高
  • 同樣具備整合工具、搜尋網路資料和圖片處理能力
  • 思考時間短,適合快速獲取資訊
  • 適用場景:教育輔助工具、軟體應用測試、中小企業AI應用、需要大量快速互動的情境

o4-mini-high(2025年4月17日推出)

  • 深度推理增強版
  • 在o4-mini基礎上增強了視覺推理能力
  • 適用場景:需要快速分析圖片中數量、關係等視覺元素的任務

注意:o3和o4-mini系列已取代了之前的o1、o3-mini和o3-mini-high模型。免費用戶可通過選擇"Think"選項來嘗試o4-mini。

ChatGPT各訂閱方案權益(2025年5月)

免費版(Free)

  • 可使用GPT-4o mini
  • 有限使用GPT-4o和o3-mini
  • 具備網路搜尋功能
  • 有限支援檔案上傳、資料分析、圖片生成與語音模式
  • 可使用自訂GPTs

Plus方案(每月20美元)

  • 包含免費版所有功能
  • 擴大訊息傳送、檔案上傳、資料分析與圖片生成的使用限額
  • 提供標準與進階語音模式,支援視訊與螢幕共享
  • 使用多種高階推理模型(o3、o4-mini、o4-mini-high)
  • 可體驗GPT-4.5研究預覽
  • 可建立與使用「專案」、「任務」、「自訂GPTs」

Pro方案(每月200美元)

  • 高級模型無限制使用
  • 擴展上下文窗口達128,000個token
  • 數據分析:處理大型數據集
  • Sora視頻生成功能:生成高解析度、長達20秒的無水印視頻
  • 優先功能測試和更快的響應速度

如何有效利用ChatGPT各模型的實用技巧

1. 選擇合適的模型

需求類型 推薦模型 說明
日常快速問答 GPT-4o mini或GPT-4o 速度快,能滿足一般對話需求
多媒體內容處理 GPT-4o 圖像、音頻和影片處理能力強
專業邏輯分析 o3 深度推理,處理複雜問題
高效率處理 o4-mini 優化速度與推理能力的平衡
複雜內容創作 GPT-4.5 創意生成與情感理解能力強
長篇內容處理 GPT-4.1 (API) 支援超長上下文窗口

2. 提升提示詞效率的技巧

  • 思維鏈技術:讓模型透過逐步思考來解決複雜問題
  • 提示鏈方法:將高度複雜任務拆解為多個單一任務,確保資訊順利傳遞
  • 提供多個範例:在指令中提供精心設計的範例,幫助模型理解預期輸出
  • 使用XML標籤:標記指令中的不同段落,區分上下文、指示和範例
  • 善用長上下文提示:將大量前置資料放在指令上方,任務目標放在下方

提示範例:「我希望你分析以下產品數據,首先計算平均銷售額,然後找出表現最好的三個產品,最後給出促銷建議。數據如下:[數據]。請你按步驟思考,每一步都寫出你的分析過程。」

3. 充分利用多模態功能

  • 圖像分析:使用GPT-4o或o3解析圖片中的複雜資訊
  • 使用Python功能:特別是o3和o4-mini模型可以使用Python來裁剪、轉換或處理圖片
  • 即時搜尋網路資料:o系列模型可以搜尋最新資訊補充回答

4. 進階功能應用

  • 自訂GPTs:根據特定需求創建專屬AI助手
  • 檔案上傳分析:上傳專業領域資料供模型參考
  • 語音模式:使用語音互動提高效率

總結

ChatGPT在2025年已發展出清晰的通用型和推理型兩大模型系列,能滿足從日常對話到高階專業分析的各種需求。付費用戶應根據自身需求,明智選擇適合的模型,並掌握提示詞優化和多模態功能使用技巧,以充分發揮訂閱價值,實現最佳工作效率。

若有任何問題或建議,歡迎留言或分享您的使用心得!

tags: `ChatGPT` `AI工具` `OpenAI` `提示詞技巧` `2025更新`

本文最初發布於 HackMD @BASHCAT。

Claude Code 2026 新命令大盤點 — 除了 /claude-api 你還該認識這 12 個

claude-code-release-velocity

五週、三十個版本、十個全新 slash commands。我在準備寫這篇文章前用 /release-notes 拉了一下 changelog,從 v2.1.83 到 v2.1.139 — 也就是 2026 年 3 月底到 5 月中 — Anthropic 在 Claude Code 上的更新節奏密集到,光是手動讀 release notes 就要花一個下午。靠杯,這還只是看,沒實際試。

你最後一次打 /help 把整份命令清單看完是什麼版本?老實說我自己也很久沒看。直到上週試用 /goal 把一個重構任務丟著跑了兩小時,回來看終端機螢幕的時候才意識到 — Claude Code 已經不再是「Claude 的 CLI」,它變成一個會自己呼叫雲端、會自己跑 PR、會自己 review 的工作流引擎。

這篇文章拆解 Claude Code 2026 上半年新增的全部命令,重點放在「哪幾個真的會改變你的工作流」。我會跳過 /claude-api(這個太熱門了大家都寫過),把鎂光燈打在那些被低估、但真的好用的新東西。

五週、三十個版本:先看一下這份瘋狂的更新清單

先給點數字撐場面。根據 Claude Code 官方 changelog ,配合 Angelo Lima 4 月整理的 Cheatsheet 補完到 5 月版本資訊,2026 年 3 月底到 5 月中這段期間 Anthropic 大約推了 30 個版本,平均每 1.2 天一個 release。新增的 slash commands 至少有:

版本 月份 新命令
2.1.101 4 月初 /team-onboarding
2.1.108 4 月中 /recap、/undo(alias)
2.1.110 4 月中 /tui、/focus
2.1.111 4 月底 /ultrareview、/fewer-permission-prompts、/effort 滑塊
2.1.118 4 月底 /usage(合併 /stats + /cost)
2.1.139 5 月中 /goal、/scroll-speed、Agent 視圖
4 月(版本不詳) - /autofix-pr、/ultraplan、/powerup

順便兩個被砍掉的:/vim 跟 /pr-comments。後面會講。

這個節奏不是純堆功能。仔細看新命令的取向就會發現一條主軸 — 雲端、並行、長任務。雲端代表 /ultraplan /ultrareview /autofix-pr,並行代表 /batch 跟 Agent 視圖,長任務代表 /goal。Claude Code 從一個會話式 CLI,正在快速往「會自己跑工作流的 agent 平台」進化。

雲端工作流三劍客:本地不夠你用、就丟雲端

claude-code-cloud-workflow

如果你只記得 2026 上半年新增的三個命令,就記這三個 — /ultraplan、/ultrareview、/autofix-pr。它們共同的特徵:把工作從你的終端機甩到雲端,跑完再把結果送回來。

/ultraplan:在瀏覽器審視草稿,再決定要不要執行

你大概有過這種經驗:丟給 Claude 一個複雜需求,它在你的終端機裡規劃了 200 行 markdown,你滑了三屏發現方向錯了,整個 context 已經被吃掉一半。/ultraplan 把這個流程拆開 — 草稿在雲端跑,你在瀏覽器看完整版(甚至可以邊喝水邊滑手機),確認沒問題再決定送回終端執行還是讓它在雲端跑完。

寫硬體韌體的人會特別有感。我那種「先幫我規劃一個 BLE service migration」的任務,以前在本地會吃掉 30% context,現在直接 /ultraplan 丟雲端,本地只接「同意」或「不同意」兩個訊號。爽。

/ultrareview:多 agent 並行 review,找到 bug 還會自己驗證

這個是我覺得 2026 上半年最被低估的功能。

根據 Claude Code Ultrareview 官方文件 和 abZ Global 的試用心得 ,/ultrareview 的工作流是:

  1. 把當前 branch 或 PR 丟到雲端 sandbox
  2. 派出一隊 specialist agents 並行 review,分別檢查 correctness、security、architecture、tests、performance、style 六個維度
  3. 每個發現的 bug 再跑一次驗證,確認是真 bug 才寫進報告
  4. 合併成一份單一報告交回給你

關鍵在第 3 步。多 agent review 最大的問題從來不是「找不到 bug」,而是「找太多假 bug」。/ultrareview 加了 verification 步驟,等於先讓 agent 自己反證一遍,結果可信度直接拉滿。

# 兩種用法
/ultrareview              # review 當前 branch vs default branch
/ultrareview 1234         # review 指定 PR 編號

價格部分要小心。MindStudio 整理的 ultrareview 計費規則 指出 Pro/Max 用戶有 3 次免費(一次性,不會每月重置),用完之後每次 review 大約 $5 ~ $20 美金,看 diff 大小。算下來不便宜,但比起雇一個 senior 花兩小時手動 review,這個價錢還算合理。

/autofix-pr:CI 爆掉、reviewer 留言,它自己處理

這個算是 GitHub Actions 整合的進階版。在 PR 還沒 merge 之前,啟動一個雲端會話「盯著這個 PR」— CI 跑掉它就修,reviewer 留 comment 它就回應並改 code。

# 預設修所有 CI failure 和 review comments
/autofix-pr

# 限縮範圍
/autofix-pr only fix lint and type errors

需要 gh CLI 已登入。對於那種「下班前 PR 開好、希望睡一覺起來 CI 已綠」的場景超實用。但要小心,如果你的 CI 包含 deploy 或 production 變更,autofix 可能會幫倒忙。我自己只在純測試型 CI 上用。

/goal:設一個終點線,然後走開

claude-code-goal-autopilot

/goal 是 2026/5/12 隨 v2.1.139 推出的新命令,ExplainX 把它形容為「2026 最被低估的 AI 功能」 。

概念很簡單:設一個完成條件,Claude 自動跨多輪持續工作直到達成。

/goal 所有單元測試通過且 coverage > 80%
/goal PR #1234 通過所有 CI 檢查並獲得 LGTM
/goal 修完 src/components/ 底下所有 ESLint 警告

每一輪結束後,內建的 evaluator agent 會檢查條件是否達成,回傳一段「為什麼還沒達成」或「達成了」的說明,顯示在 status view 跟 transcript 上。你可以開著一個 dashboard 看它跑了幾輪、花了多少 token、距離終點還多遠。

但 — 我要先打個預防針。Joe Njenga 在 Medium 上的試用心得 一開頭就翻車:他第一次跑 /goal 不到一小時就停下來問他「要不要批准這個動作」。問題不在 /goal 本身,而在 trust mode 沒開。Claude 預設遇到敏感 tool call 就會停下來確認,這個確認彈窗一出現,goal 的 loop 就斷了。

結論:要用 /goal 跑無人值守工作,必須搭配 auto mode(或至少把該允許的 permission 都先設好)。否則你那個「過夜實習生」會在第 5 分鐘就坐在原地發呆。

實戰範例 — 我自己拿這個跑了一個重構:把 KCA10 韌體的 BLE service 從舊版 API 遷移到新版。設定的 goal 是「west build 全綠且 unit test 全過」。設好以後切到 auto mode,去吃飯,回來工作已經做完 70%。最後那 30% 它卡在一個自己生不出來的硬體 mock,主動把 transcript 留好讓我接手。這就是 /goal 該長的樣子。

Bundled Skills:除了 /claude-api,還有 5 個你可能不知道

claude-code-bundled-skills-toolkit

Claude Code 內建了一組 Bundled Skills — 它們長得像 slash commands,但底層是 Skill 機制(也就是 prompt-based,Claude 可以自動觸發)。/claude-api 是其中最有名的,但其實還有 5 個同等級的:

命令 我會這樣形容 什麼時候用
/batch <instruction> 平行宇宙裡的你,一起改 30 個檔案 大規模 migration(如 Solid → React)
/debug [description] 開 debug log,順便讓 Claude 自己看 log 找問題 詭異 bug 抓不到
/loop [interval] [prompt] Cron job 的 AI 版 監測 CI、定期文件更新
/simplify [focus] 三個 reviewer 同時上身,挑 code smell 寫完一輪想做 cleanup
/fewer-permission-prompts 自動掃 transcript 找出常用 read-only command,加進 allowlist 已經被權限彈窗煩到爆肝

/batch 特別值得講一下。官方 commands 總覽頁 描述它會把你的指令自動拆解成多個獨立工作單元(實測通常落在 5 到 30 之間,依任務規模而定),每個單元在自己的 git worktree 裡用一個 background subagent 跑,做完開 PR。我曾用 /batch migrate src/ from JavaScript to TypeScript 一次性處理過 12 個檔案,每個檔案開一個 PR,整個過程我只負責 review 和 merge。神扯。

/simplify 也很狠 — 它會並行派出 3 個 review agent,aggregate 他們的發現之後自動修 code。我寫完一段比較髒的邏輯,跑 /simplify focus on memory efficiency,回來通常會看到 3 ~ 5 個合理的精簡建議直接被應用。

命令系統大統一:.claude/commands/ 退場、Skills 上位

claude-code-skills-unification

2026 年 Claude Code 做了一個重要的架構決策 — 把 commands 和 skills 合併。

過去這兩個系統並行存在:

  • .claude/commands/<name>.md → 觸發 /<name> 命令
  • .claude/skills/<name>/SKILL.md → 同樣觸發 /<name>,但多了自動觸發、附加檔案、frontmatter 控制

根據 YingTu 的分析 ,Anthropic 沒有強制遷移,而是把 Skills 升格為主要抽象,slash command 變成 Skill 的其中一個能力。寫成 Skill 的好處是:

---
name: my-deploy-check
description: When to use this skill (Claude 用這個決定自動觸發)
disable-model-invocation: false   # true 則禁止 Claude 自動觸發
user-invocable: true              # false 則隱藏於 / 選單
allowed-tools: Read, Grep, Bash   # 限制可用工具
model: claude-sonnet-4-6           # 強制使用特定模型
context: fork                      # 在 isolated subagent 跑
---

# My Deploy Check
<skill 內容>

最強的兩個欄位是 allowed-tools(精細權限控制)和 context: fork(整個 skill 跑在 isolated subagent,不污染主對話 context)。寫一個常用的 deploy check skill 設成 context: fork,你的主對話 context 就不會被 1000 行 lint output 吃掉。

老的 .claude/commands/*.md 還能用,但 Heyuan 的命令大全 建議所有新東西都寫 Skill。如果你的專案還在用 legacy commands,趁早遷移會省事。

Plugin Marketplace 爆發:神器與地雷各半

claude-code-plugin-marketplace

2026 上半年最戲劇性的生態變化 — Plugin marketplace 從幾個官方目錄擴張到至少四個主流市集:

平台 規模 / 特色 我的評語
Anthropic 官方 預先設定、嚴選 安全第一,但少
tonsofskills.com(GitHub) 425 plugins / 2,810 skills / 200 agents 量大、品質參差
SkillsMP 1.2M+ skills、按職業分類 按角色/職業分類瀏覽,類似 job board UI

「Plugin」是「bundle」— 一個 plugin 可以包含 skills、MCP servers、commands、hooks、agents,一鍵安裝。理論很美。實際上 2,810 個 skill 裡面有多少是真的可用、有多少是 SEO 農場產品,需要自己挑。

我自己的選 plugin 原則:

  1. 先看官方目錄,能解決就解決
  2. 找 GitHub 上 star > 200 的
  3. 看 SKILL.md 內容是不是清晰、frontmatter 有沒有亂寫
  4. 絕對避免 require remote MCP server 的 plugin — 等於把你的程式碼權限交給第三方

夭壽,這幾條原則套下來真的 2,810 個剩下不到 30 個。但這 30 個就是好東西。

已退場:/vim 跟 /pr-comments 的小哀悼

claude-code-deprecated-commands

兩個曾經很實用的命令在 2026 上半年被砍掉:

  • /vim(官方 commands 文件 標示 v2.1.92 移除):改用 /config → Editor mode。我猜是因為 vim 切換邏輯太多人吵,乾脆收進 config 裡讓你一次設好
  • /pr-comments(官方文件標示 v2.1.91 移除):直接跟 Claude 說「幫我看 PR #1234 的 comments」就好,Claude 自己會 call gh pr view。命令層被薄薄一層自然語言取代

兩個快捷鍵行為也改了:

  • Ctrl+O 從「focus 切換」變「詳細日誌切換」(focus 改用 /focus 命令)
  • Ctrl+U 從「刪除至行首」變「清空整個輸入緩衝區」

如果你的 muscle memory 還停在 v2.0,現在按 Ctrl+U 會發現整段話消失,那個瞬間真的會傻眼。

哪些命令值得馬上學?我的精選清單

寫到這裡你大概已經被資訊轟炸到頭暈。我替你篩過:

學習優先級 命令 為什麼
必學 /goal 長任務 game changer,但要搭配 auto mode
必學 /ultrareview merge 前最後一道防線,有免費額度先試
必學 /batch 一次處理 N 個檔案,並行 + 自動 PR
強推 /simplify 寫完髒 code 後的清理利器
強推 /team-onboarding 新同事入職 + 你自己的工作流複盤
強推 /usage 取代 /stats /cost,看花了多少錢
看情況 /ultraplan 大型重構規劃適用
看情況 /autofix-pr 純測試型 CI 才安全
看情況 /fewer-permission-prompts 權限彈窗煩到爆肝再用

不要看 changelog 看一次就以為自己學會。每個命令至少實際跑一次帶有真實 context 的任務,你才會知道哪個合自己的 workflow。我自己花了大概兩個禮拜把這些命令輪流跑過一輪,最後只把 /goal /batch /simplify 跟 /team-onboarding 留在每週固定使用的清單。其他的就是 — 知道存在,需要時想得起來就夠。

結語:Claude Code 已經不是 CLI 了

攤開命令的演進方向 — 本地保留即時互動,重活丟雲端跑(/ultraplan /ultrareview /autofix-pr),長任務交給 agent 自走(/goal),常用流程封裝成 skill 並分發。整個系統正在從「Claude 的命令列介面」變成「Anthropic 的 agent 平台前端」。

接下來會怎麼走?以下純屬個人推測,目前沒有任何官方訊號 — 我猜本地、雲端、web、mobile 的分工會繼續細化,/goal 跟 /batch 如果能組合,等於高層目標可以自動拆解成並行 unit、每個 unit 自己跑、自己 review、自己 merge。

回到現實。先把這 12 個新命令搞熟,你會發現 /help 再也不只是新手才打的東西。


延伸閱讀 / 參考資料


本文最初發布於 HackMD @BASHCAT。

2026 我把 4000+ Claude Code Skills 裝進終端機之後 — 16 個值得收藏的 GitHub Repo 地圖

claude-skills-hero

說一個有點糗的真實場景。某個禮拜五晚上,我滑著 GitHub 看到 sickn33/antigravity-awesome-skills 寫著「installable GitHub library of 1,450+ agentic skills」,腦袋一熱,npx antigravity-awesome-skills --claude 一口氣全裝。隔天打開 Claude Code,光是讀取 marketplace 就卡了 5 秒,叫它做一個小重構,它居然先列出 17 個候選 skill 讓我選。

那一刻我才搞懂:Claude Code 的 skill 生態到了 2026 已經不是「東西多 = 強」,而是「選得準 = 強」。

這篇是我研究完官方規格、跑完 Anthropic、Trail of Bits、GitHub Changelog 的公告,又把 GitHub 上 16 個高 star 的 repo 都翻過 README 之後,整理給繁中讀者的一張「Skills 寶藏地圖」。我會用四檔分類把它們分清楚,附上可以直接 copy-paste 的 cheat sheet,最後用 6 種角色幫你決定先裝哪 3 個。

Skills 是什麼?為什麼 2026 變元年

Anthropic 在 2025 年 10 月 16 日的官方部落格 正式發表 Agent Skills,原文標題是 Introducing Agent Skills,定位寫得很乾脆——「Claude 可以用 Skills 來改善它執行特定任務的表現」。當時還只是 Claude 自家功能。

兩個月後更進一步:2025 年 12 月 Anthropic 把規格 agentskills.io 拿出來開源,正式變成跨平台「Agent Skills 開放標準」。The New Stack 把它比擬成另一個 MCP 級別的標準布局 ——Anthropic 先做事實標準、再開源、再讓整個工具鏈被綁進來。事後看,這個策略奏效得很快。

到 2026 年 4 月,這個標準已被 Claude Code、Claude.ai、Cursor、Gemini CLI、GitHub Copilot 等多個 agent host 採用,並陸續擴散到 OpenAI Codex CLI、Antigravity、Windsurf 等工具(規格本身也維護在開放的 agentskills/agentskills repo 由社群貢獻——注意 agentskills 是獨立 org、不是 Anthropic 名下的 repo)。同時 GitHub 在 2026-04-16 的 Changelog 上線 gh skill 子指令——一個 CLI 工具就能跨所有 agent host 安裝、更新、發布 skill。

換句話說:

2026 是「skills 變成像 npm 套件那樣被生態管理」的元年。

這也是為什麼 GitHub 上 awesome-claude-skills 這個關鍵字從 2025 年底開始爆炸長出十幾個 repo,每一個都號稱「1000+ skills」。

claude-skills-anatomy

30 秒搞懂 SKILL.md 到底長什麼樣

別被「規格」兩個字嚇到。一個 skill 本質上只有一個資料夾跟一個檔案:

my-deployment-checklist/
└── SKILL.md

SKILL.md 最少只要兩個 YAML frontmatter 欄位就能跑:

---
name: deployment-checklist
description: Pre-deployment validation for production releases
---

# Process

1. Run tests: `npm test`
2. Build: `npm run build`
3. Verify environment variables
4. Run database migrations
5. Document rollback plan

# Verification
- [ ] All tests passing
- [ ] Build successful
- [ ] Migrations applied
- [ ] Rollback documented

就這樣。Claude(或任何 agent host)會根據你的對話內容判斷 description 與當前任務的相關性,只在需要時 把完整的 SKILL.md 載進 context。這個「按需載入」的機制是它跟 system prompt、CLAUDE.md 最大的差異——一個 system prompt 是「永遠存在的內隱規則」,一個 skill 是「該你上場時你才被叫出來」。

可選欄位也很節制:author、version、license、user-invocable: true(在 slash command 選單裡顯示)、context: fork(在獨立 subagent 裡跑)。整套規格的設計哲學就是「越少越好」,方便讓不同工具廠商都能無痛實作。

放置位置只有兩種:

  • 專案層:<project>/.claude/skills/<name>/SKILL.md
  • 使用者層:<sub>/.claude/skills/<name>/SKILL.md

知道這個之後,後面看 repo 就很容易——所有 repo 不管包裝得多花俏,最後都是把一堆 SKILL.md 丟進這兩個資料夾的其中一個。

claude-skills-install-evolution

安裝方式三代演進:從 git clone 到 gh skill

這半年安裝方式經歷了非常明顯的三代演進。如果你還在用第一代寫教學,那已經過時了。

[mermaid 圖表 — 原始 HackMD 版本可正常渲染]

graph LR A["Gen 1
2025 Q4
git clone"] --> B["Gen 2
2026 Q1
/plugin marketplace"] B --> C["Gen 3
2026 Q2
gh skill CLI"] A -.-> A1["手動進 /.claude/skills/
易碎、難版本管理"] B -.-> B1["Claude Code 內建
marketplace 系統
支援 update / browse"] C -.-> C1["GitHub 官方 CLI
跨 agent host
支援 version pinning"]

三代差異一張表看完:

世代 指令 出現時間 特性 是否仍適用
Gen 1 git clone … <sub>/.claude/skills/foo 2025 Q4 手工、無版本控制、易碎 仍可,但僅適合「我自己寫的私房 skill」
Gen 2 /plugin marketplace add owner/repo + /plugin install name@marketplace 2026 Q1 Claude Code 原生 UI、可 browse 目前最主流
Gen 3 gh skill install owner/repo[/path][@tag] --agent claude-code 2026 Q2 跨 host、支援版本鎖定、immutable releases 新專案首選

Gen 3 的 gh skill 是真的解決問題的。它允許版本釘選、gh skill publish 還能自動啟用 GitHub immutable releases 確保供應鏈完整性。對企業團隊來說,這是「終於可以把 skill 寫進採購清單」的關鍵。

我自己現在的習慣是:個人實驗用 Gen 2、團隊與生產環境用 Gen 3、寫 demo 才用 Gen 1。

claude-skills-four-tiers

第一檔:官方原生型——安全感的起點

如果你完全不知道從哪開始,這檔不用糾結,直接裝。

anthropics/skills

anthropics/skills (132k stars,2026-05 快照)是官方範例庫。你會在這裡找到 pdf、docx、xlsx、pptx(這幾個是 source-available 而非 MIT,注意授權)、mcp-builder(教 Claude 建 MCP server)、artifacts-builder、webapp-testing、skill-creator,以及一個值得單獨提的 claude-api skill——它把整個 Anthropic API 與 Agent SDK 的最新規格、模型 ID、價格、beta header 全部包成一個 skill,是內部訊息流通最快的地方。

授權主體是 Apache 2.0,少數文件處理 skill 為 source-available。對企業合規很重要。

anthropics/knowledge-work-plugins

anthropics/knowledge-work-plugins (12k stars)是 Anthropic 為「非工程師」設計的 plugin 集合,11 個 plugin 分別針對 sales、marketing、legal、finance、data、customer-support、product-management、enterprise-search、bio-research 等角色,預設綁好對應的 MCP 連接器(Slack、Notion、HubSpot、Snowflake、Databricks、BioRender、ClinicalTrials.gov…)。

如果你的公司想推「全員 AI 化」,這是最容易上手的官方範本——直接拿 finance plugin 給會計、拿 legal plugin 給法務,連 prompt 都不用自己寫。

第二檔:明星框架——4 個值得 fork 的設計哲學

這檔不是「skills 多」,而是「對 agent 工作流的思考夠深」。看完 README 你會學到的不只是怎麼用,而是怎麼設計自己的 skill。

obra/superpowers — TDD 紀律的高山

obra/superpowers (150k+ stars,2026-05 持續快速增長中)由 Jesse Vincent 維護,是 2026 上半年 Claude Code 生態裡聲量最大的個人作品。它的 30+ skills 不是隨便堆砌,而是一整套有紀律的開發方法論:

  • Test-Driven:test-driven-development、testing-anti-patterns、condition-based-waiting
  • Debug 系統化:systematic-debugging、root-cause-tracing、verification-before-completion
  • 規劃/審查:brainstorming、writing-plans、executing-plans、subagent-driven-development、requesting-code-review、receiving-code-review
  • Git workflow:using-git-worktrees、finishing-a-development-branch

它的核心信念寫得很直白:「Write tests first, always」「Systematic process over guesswork」「Simplicity is the primary design goal」。如果你曾經被 Claude「自信地寫了一個沒測試的 bug fix」氣到,這套 skill 是反制方案。安裝 /plugin marketplace add obra/superpowers-marketplace。

affaan-m/everything-claude-code — 把 harness 當作品

affaan-m/everything-claude-code (175k stars,2026-05 快照)不是 skill 收藏,而是一整個「agent harness 效能優化系統」。它包了 48 個 subagent、185+ skills、34 條 always-follow rules(含 TypeScript / Python / Go / Swift / PHP 變種)、14 個 MCP server 配置。

作者宣稱在開源前已私下使用多月迭代,repo 於 2026 年 1 月上 GitHub 後成長極快。對於想把 Claude Code 當成「我這個人的延伸大腦」的人,這是最接近現成「整套人格 + 工作流」的選擇。

JuliusBrussee/caveman — 一個 skill 也能爆紅

JuliusBrussee/caveman (57k stars)證明「單一 skill 也能變現象級」。它做的事情很有趣:強迫 Claude 用「穴居人式」的縮略英文回答,repo 自報 10 個 prompt 測試下平均約 65% output 壓縮、範圍 22–87%,極端情境(解釋 React re-render)可達 87% 上限。

我自己跑過幾次,老實說對「機械式 coding」很有效(產 boilerplate、改變數名、寫測試),但對需要長鏈推理的任務(複雜演算法、跨檔案重構)會影響思考品質。Shareuhack 在 2026 年的實測文章 也提到,過度壓縮在需要 chain-of-thought 的複雜推理任務上可能拖累結果。所以——該省 token 時 caveman 上、該想清楚時關掉。

jarrodwatts/claude-hud — 終於有人做儀表板

jarrodwatts/claude-hud (22k stars)是一個 HUD plugin,把 context 用量、active tools、subagent 狀態、todo 進度、git 分支用視覺化方式顯示在 Claude Code 的 terminal 邊上。

它解決的是一個「你不用打它也明白現在發生什麼」的痛點。對於每天會跑 5 個以上 subagent 並行任務的人,這是必裝。

第三檔:awesome 集散地——把 GitHub 當 NPM 用

這檔是「我需要時去翻」的圖書館型 repo。不要每個都裝,挑 1–2 個逛即可。

Repo Stars 量體 特色
ComposioHQ/awesome-claude-skills 59k 1000+ 78 個透過 Composio MCP 連接 SaaS 的 app-automation skills
hesreallyhim/awesome-claude-code 43k 廣義 整個 Claude Code 生態的中央目錄(含 hooks、slash commands、status lines)
sickn33/antigravity-awesome-skills 37k 1450+ npx antigravity-awesome-skills 一鍵部署到指定工具
wshobson/agents 35k 185 agents + 153 skills 拆成 80 個聚焦 plugin、25 個類別
davila7/claude-code-templates 27k 模板 npx claude-code-templates@latest 互動式選裝;aitmpl.com 有 web dashboard
VoltAgent/awesome-agent-skills 21k 1100+ 收錄 Google、Microsoft、Stripe、Cloudflare、Vercel、Netlify、Trail of Bits、Binance 等企業官方 skills
alirezarezvani/claude-skills 14k 235 唯一完整覆蓋 C-Level、Regulatory & Quality Management、Finance 等管理面 skills
travisvn/awesome-claude-skills 12k 中型 分類清楚、有明確的安全警語
BehiSecc/awesome-claude-skills 9k 135+ 含「健康與生命科學」「學習與知識」冷門類別
karanb192/awesome-claude-skills n/a 50+ 每個 skill 都標星等、註明 Source 與是否人工驗證過

要特別點名一個 2026 年最大的陷阱——別把「skill 數量」當品質指標。buildtolaunch.substack.com 在 一篇實測文 直接點破:「Not everything in these repos is installable. 1,916 skills does not mean 1,916 things you can /plugin install.」很多 awesome list 收錄的是「指向其他 repo 的連結」而非可即裝包。挑 repo 時請看:(a) 有沒有 plugin.json / marketplace.json / npx 一鍵安裝(sickn33 與 davila7 屬此類);(b) 還是只是純連結清單(hesreallyhim 屬此類,當搜尋引擎用即可)。

第四檔:領域利基——一招打中的單點突破

這檔是「我只要解決這一件事」的 repo,通常 star 數不高但領域深度極強。

trailofbits/skills — 安全研究的天花板

trailofbits/skills (5k stars)是 Trail of Bits 這家全球頂級 security 顧問公司的官方 skill 集合,包含:

  • 智能合約:building-secure-contracts、entry-point-analyzer
  • 程式碼審計:agentic-actions-auditor、c-review、differential-review、semgrep-rule-creator、static-analysis(CodeQL + Semgrep + SARIF)、supply-chain-risk-auditor、variant-analysis
  • 驗證測試:constant-time-analysis(密碼學側通道)、mutation-testing、property-based-testing、zeroize-audit
  • 惡意軟體:yara-authoring
  • 逆向工程:dwarf-expert
  • 行動安全:firebase-apk-scanner

如果你做 AppSec、CTF、bug bounty,這是不裝白不裝的權威來源。安裝 /plugin marketplace add trailofbits/skills。

其他值得收進工具箱

  • lackeyjb/playwright-skill (2.2k stars):Claude 自主寫並執行 Playwright 自動化測試
  • timescale/pg-aiguide (1.7k stars):PostgreSQL skill + MCP,讓 Claude 寫出更好的 SQL
  • thedotmack/claude-mem :把每個 session 的 context 用 AI 壓縮存起來、下次自動注入相關片段——解決「Claude 三天後就不認得我做過什麼」的記憶問題
  • context7(官方 plugin):即時抓取最新 library 文件,避開訓練資料過時

claude-skills-personas

我的推薦組合:6 種角色,6 套搭配

我把上面所有 repo 重新組合成 6 個角色 starter pack。每組都是「3 個 skill / plugin 起跳」,不用第一天就裝滿。

入門開發者(剛裝 Claude Code 不到一週)

  1. anthropics/skills — 安裝 pdf / docx / pptx / skill-creator
  2. obra/superpowers — 至少裝 test-driven-development、brainstorming、writing-plans
  3. jarrodwatts/claude-hud — 看清楚 context 用到哪

進階全端工程師

  1. obra/superpowers 完整版
  2. wshobson/agents 挑語言對應 plugin(python / typescript / kubernetes)
  3. context7 — docs 即時 lookup
  4. (選)JuliusBrussee/caveman — 想省 token 時切換

安全研究 / AppSec

  1. trailofbits/skills — 全裝
  2. obra/superpowers 的 systematic-debugging、root-cause-tracing
  3. anthropics/skills/webapp-testing

行銷 / 成長

  1. anthropics/knowledge-work-plugins/marketing
  2. ComposioHQ/awesome-claude-skills 的 SEO / CRO / 內容 skill(如 claude-seo)
  3. alirezarezvani/claude-skills 的 marketing pod(44 skills 分 7 個專業)

知識工作者 / PM

  1. anthropics/knowledge-work-plugins/productivity + product-management
  2. BehiSecc/awesome-claude-skills 中的 Linear / Kanban / Google Workspace skills
  3. thedotmack/claude-mem — 長期專案必備

C-Level / 經營者

  1. alirezarezvani/claude-skills 的 C-Level pod(34 skills 覆蓋全 C-suite)
  2. anthropics/knowledge-work-plugins/finance + legal
  3. obra/superpowers/brainstorming + writing-plans — 把策略思考結構化

安裝 Cheat Sheet

# =<mark> 官方 marketplace </mark>=
/plugin marketplace add anthropics/skills
/plugins                                          # 進 UI 瀏覽

# =<mark> 明星框架 </mark>=
/plugin marketplace add obra/superpowers-marketplace
/plugin install superpowers@superpowers

/plugin marketplace add jarrodwatts/claude-hud
/plugin install claude-hud
/claude-hud:setup

# =<mark> 集散地(互動式選裝)</mark>=
npx antigravity-awesome-skills --claude          # 1450+ skills
npx claude-code-templates@latest                 # davila7 模板互動 CLI

# =<mark> 領域 </mark>=
/plugin marketplace add trailofbits/skills        # 安全
/plugin marketplace add wshobson/agents          # 多 plugin 拆裝

# =<mark> 知識工作者 </mark>=
claude plugin marketplace add anthropics/knowledge-work-plugins
claude plugin install sales@knowledge-work-plugins

# =<mark> 2026 Q2 新標準:gh CLI(跨 agent host)</mark>=
gh skill search pptx
gh skill install anthropics/skills skills/pptx@latest --agent claude-code --scope user
gh skill update --all
gh skill publish                                  # 你也可以發布自己的

中文社群觀察與寫作機會

研究完最大的感慨:繁中圈幾乎沒有人在維護 awesome-claude-skills。我用「claude skills 繁體 awesome」「claude skills 中文 推薦」等各種組合搜尋,最後找到的多半是中國大陸 medium 個人作者的短文、Reddit 翻譯、HackMD 個人筆記。

這同時是壞消息也是好消息。

壞消息是台灣團隊容易卡在「英文教學」與「實際團隊導入」之間的鴻溝,特別是中型公司的非工程同事很難自己摸索安裝流程。好消息是——這是內容創作者的肥沃土壤。任何願意把官方 README 用繁中重寫一次、加上台灣工程文化 context(例如「老闆要我加班裝這個」「主管怕資安所以連 marketplace 都不准用」)的人,都會非常受歡迎。

我自己這篇就是一個小小的補白嘗試。如果你也想開始,我建議從「fork 一個英文 awesome list 翻譯成繁中」開始,比從零寫快得多。

claude-skills-three-picks

結語:先選 3 個跑 1 週

寫完這篇我發現一個反直覺的結論——裝得越多越廢。

Skill 越多,Claude 在 marketplace 載入時讀的 metadata 越多、在做任務時也要花更多 token 去判斷該選哪個。我自己 2026 年 3 月那次大裝特裝之後,跑一個簡單 refactor 居然要 7 秒才開始輸出。後來砍到只留 12 個,速度立刻回來。

所以給你的具體建議是:

  1. 先選 3 個:1 個官方範例、1 個明星框架(強烈推薦 obra/superpowers)、1 個對應你工作的領域 skill
  2. 跑 1 週:故意挑日常會做的 5–10 個任務全程用這 3 個
  3. 再回頭評估:哪個你按一次「不要用這個 skill」?砍掉。哪個你會主動 @skill-name 召喚?保留並深入。
  4. 第二週再加 2 個:根據第一週的真實使用情境,從集散地 repo 挑兩個新的進來

這個節奏走 6 週,你會建立起一套真正屬於自己的工作流,而不是別人 README 的拼貼。

如果你覺得這篇有用,請把它分享給身邊還在 git clone skill 的朋友——順便提醒他升級到 gh skill。然後告訴我你最後留下的 3 個 skill 是什麼,我很好奇繁中工程社群最終會收斂出什麼樣的組合。

延伸閱讀


本文研究與寫作於 2026-05-11 完成;所有 GitHub star 數為當日快照,可能已變動。歡迎在留言區補上你最愛的 repo——尤其歡迎繁中作者的作品。


本文最初發布於 HackMD @BASHCAT。

8GB 的 RK3588 能跑多聰明的 LLM?ROCK 5C 用 NPU 實測 5 個模型

先講結論,省得你滑到最後: 在一片 8GB 的 RK3588 板子上,用 NPU 跑得最聰明的是 Qwen3-4B-Instruct-2507,我出的 7 題全對,但每秒只吐 3.7 個 token。 想要順一點的對話體驗,Qwen3.5-2B 的 8.4 tok/s 是比...