同一個模型、同一份考卷,只換掉外面那層程式,Terminal-Bench 2 的通過率就從 69.7% 跳到 77.0%。這不是我瞎掰的數字,是 2026 年 5 月一篇 arXiv 論文 Stop Comparing LLM Agents Without Disclosing the Harness 整理出來的結果;同一篇還提到,SWE-bench Verified 上光換 scaffold 就能差到 15 個百分點。
那層「外面的程式」,就是這篇要講的 agent harness:它決定模型看得到什麼 context、能用哪些工具、出錯時怎麼重試、什麼時候該停。模型可以用租的,harness 才是你自己的。
我最近把 Mario Zechner 寫的 pi 從原始碼到文件翻了一輪,順便整理出一條「自己從零打造 coding agent harness」的路線。pi 很適合當藍本,原因很單純:它夠小、夠透明,而且每一層都拆得很乾淨。
環境與前置條件
- 範例語言:Python 3.11+,套件
anthropic(pip install anthropic)- 需要
ANTHROPIC_API_KEY環境變數- 前置知識:會用終端機、看得懂 JSON 與基本的 HTTP API 概念
- 文中 pi 的資訊以 2026-10 的 Pi 1.0 為準
pi 是什麼,為什麼拿它當藍本
pi 的作者是 libGDX 的作者 Mario Zechner。他在 Mastra 的演講 裡講得很直白:他一開始超愛 Claude Code,後來受不了功能越加越多、每天在背後變動的隱藏 context 注入、終端畫面一直閃,還有完全沒辦法改的擴充性,所以乾脆自己寫一個。
他在 部落格長文 裡把 pi 拆成四個套件,這也剛好是一個 harness 該有的四層:
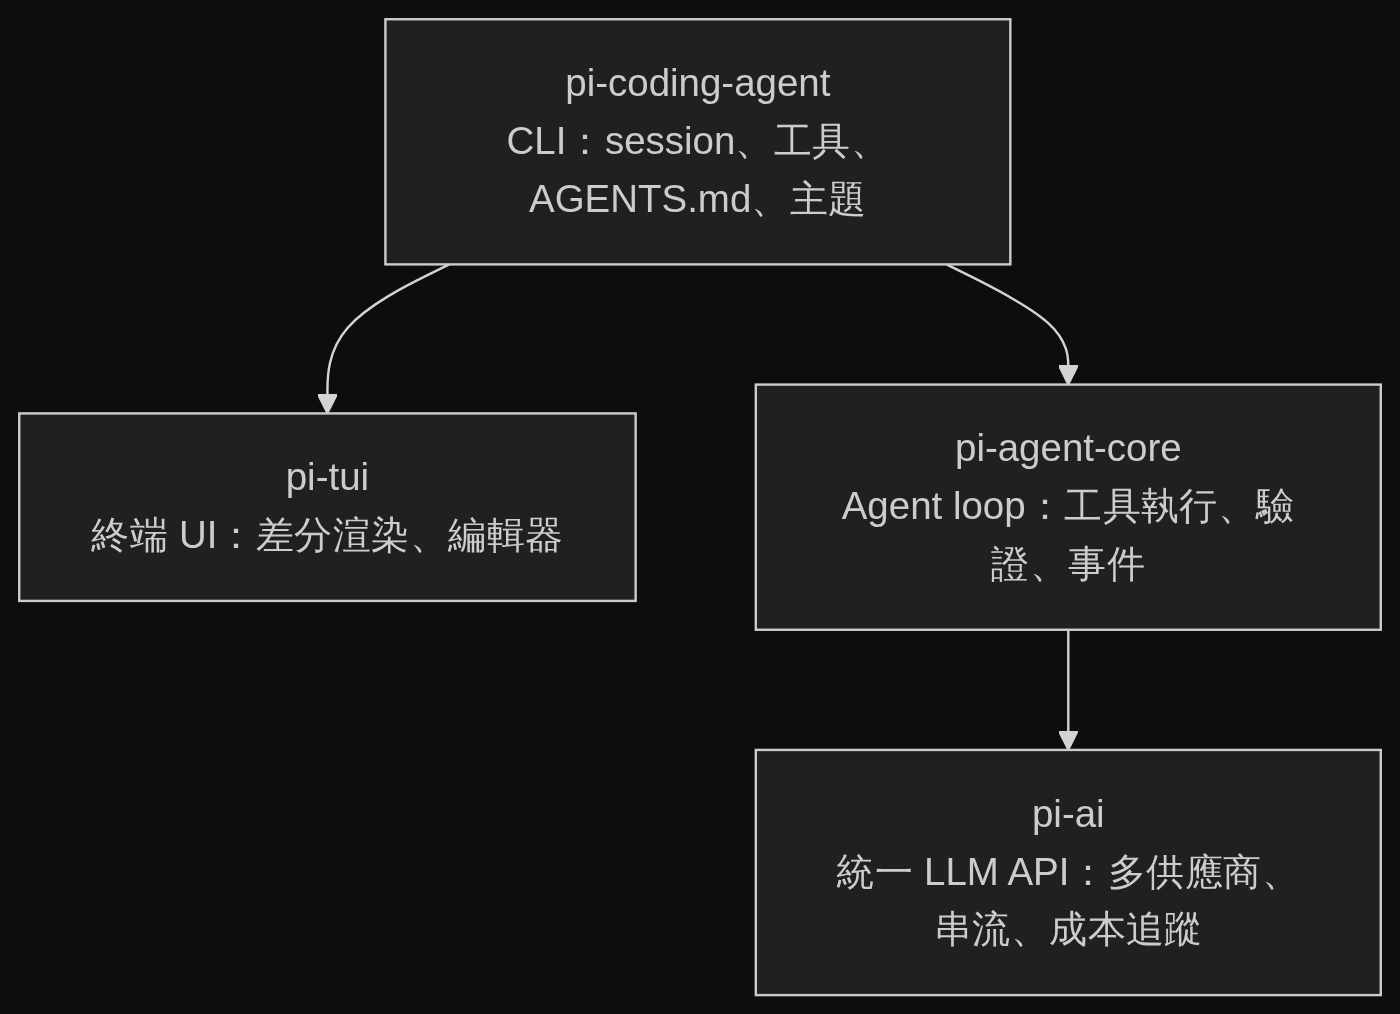
最底層 pi-ai 負責跟各家模型講話,pi-agent-core 跑迴圈和工具,pi-tui 畫畫面,最上面的 pi-coding-agent 把東西組起來。現在專案已經搬到 Earendil 名下,npm 套件叫 @earendil-works/pi-coding-agent,2026 年 10 月 1 日剛發布 Pi 1.0。
pi 最有名的是它的「少」:作者在 2025 年 11 月的文章裡寫,預設只有 4 個工具(read、write、edit、bash),系統提示加上工具定義低於 1000 tokens;對照組是動輒上萬 tokens 的系統提示。Pi 1.0 加上 Codemode 之後變大了一些,官方 changelog 給的數字是:預設工具加 Codemode,一次 GPT-5.6 請求大約 3,300 tokens(優化前約 5,300)。還是很省。少,代表你看得懂它送給模型的每一個字,這點對想自己做 harness 的人來說超重要。
第一步:300 行就能跑的最小迴圈
很多人以為 coding agent 背後有什麼黑魔法。Thorsten Ball 在 How to Build an Agent 這篇裡用一句話戳破:它就是 LLM、一個迴圈,加上夠多的 token。他用 Go 寫了大約 300 行、3 個工具,就做出一個能改檔案的 agent。
迴圈的邏輯只有這樣:把對話送給模型;模型要求呼叫工具,就執行工具、把結果塞回去、不等使用者直接再呼叫一次模型;模型不再要工具了,才回頭等使用者輸入。pi 的 agent loop 本質上也是這樣,作者在 2025 年的文章裡還特別提到,它刻意不設最大步數。
下面是我照 pi 的 4 個工具寫的 Python 最小版,存成 mini_agent.py 就能跑:
# mini_agent.py — pip install anthropic;需要 ANTHROPIC_API_KEY
import json
import pathlib
import subprocess

import anthropic

client = anthropic.Anthropic()
MODEL = "claude-sonnet-5-5"
SYSTEM = (
    "You are an expert coding assistant. Use bash for ls/grep/find. "
    "Read files before editing them. Be concise."
)

TOOLS = [
    {"name": "read", "description": "Read a text file. offset is a 1-based line number.",
     "input_schema": {"type": "object", "properties": {
         "path": {"type": "string"}, "offset": {"type": "integer"}, "limit": {"type": "integer"}},
         "required": ["path"]}},
    {"name": "write", "description": "Create or overwrite a file.",
     "input_schema": {"type": "object", "properties": {
         "path": {"type": "string"}, "content": {"type": "string"}},
         "required": ["path", "content"]}},
    {"name": "edit", "description": "Replace oldText with newText. oldText must match exactly once.",
     "input_schema": {"type": "object", "properties": {
         "path": {"type": "string"}, "oldText": {"type": "string"}, "newText": {"type": "string"}},
         "required": ["path", "oldText", "newText"]}},
    {"name": "bash", "description": "Run a shell command and return its output and exit code.",
     "input_schema": {"type": "object", "properties": {
         "command": {"type": "string"}, "timeout": {"type": "integer"}},
         "required": ["command"]}},
]


def run_tool(name: str, args: dict) -> str:
    if name == "read":
        lines = pathlib.Path(args["path"]).read_text().splitlines()
        start = max(args.get("offset", 1), 1) - 1
        return "\n".join(lines[start:start + args.get("limit", 2000)])
    if name == "write":
        path = pathlib.Path(args["path"])
        path.parent.mkdir(parents=True, exist_ok=True)
        path.write_text(args["content"])
        return f"wrote {len(args['content'])} chars to {path}"
    if name == "edit":
        path = pathlib.Path(args["path"])
        text = path.read_text()
        hits = text.count(args["oldText"])
        if hits != 1:
            raise ValueError(
                f"oldText matched {hits} times in {path}; it must match exactly once. "
                "Re-read the file and include more surrounding lines.")
        path.write_text(text.replace(args["oldText"], args["newText"]))
        return "ok"
    if name == "bash":
        r = subprocess.run(args["command"], shell=True, capture_output=True,
                           text=True, timeout=args.get("timeout", 120))
        out = r.stdout + r.stderr
        if len(out) > 20000:  # 保留頭尾,避免一次塞爆 context
            out = out[:10000] + "\n...[truncated]...\n" + out[-10000:]
        return f"exit={r.returncode}\n{out}"
    raise ValueError(f"unknown tool: {name}")


def main() -> None:
    messages = []
    while True:
        try:
            messages.append({"role": "user", "content": input("\n> ")})
        except EOFError:
            break
        while True:  # 內圈:模型還要工具就一直跑
            resp = client.messages.create(model=MODEL, max_tokens=8192, system=SYSTEM,
                                          tools=TOOLS, messages=messages)
            messages.append({"role": "assistant", "content": resp.content})
            results = []
            for block in resp.content:
                if block.type == "text":
                    print(block.text)
                elif block.type == "tool_use":
                    print(f"  [{block.name}] {json.dumps(block.input, ensure_ascii=False)[:120]}")
                    try:
                        output, is_error = run_tool(block.name, block.input), False
                    except Exception as e:  # 錯誤也要回給模型,讓它自己修正
                        output, is_error = f"Error: {e}", True
                    results.append({"type": "tool_result", "tool_use_id": block.id,
                                    "content": output, "is_error": is_error})
            if not results:
                break
            messages.append({"role": "user", "content": results})


if __name__ == "__main__":
    main()
跑起來之後,丟一個故意寫壞的單元測試給它,叫它修到綠燈。第一次看到它自己 pytest、讀錯誤、改 code、再跑一次,那種「欸,真的會動」的感覺,我覺得每個工程師都該體驗一次。
有個小差異要講清楚:pi 的 bash 工具預設沒有 timeout,長時間的工作交給 tmux;我這裡設 120 秒,只是讓教學範例不會卡死。
工具品質才是體感的來源
迴圈寫出來只要一個下午,但「好不好用」幾乎都卡在工具細節。最典型的是 edit 工具的錯誤訊息。
Before,很多人第一版會這樣寫:
if args["oldText"] not in text:
    return "not found"
模型拿到一句 not found,只會亂猜、換個字串再試,越試越歪。After,就是上面範例那樣:告訴它比對到幾次、為什麼不行、下一步該做什麼(重讀檔案、多帶幾行上下文)。這一個改動帶來的差別,以我自己的體感,比換一個模型還有感。
pi 在這層還做了一個我很喜歡的設計:工具結果拆成兩份。output 給模型看,details 給 UI 用。比如 edit 工具回給模型的是一句「ok」,但 UI 拿到的是完整 diff,可以畫成漂亮的對照。參數驗證則用 TypeBox 加 AJV,驗證失敗的詳細錯誤會直接丟回給模型,讓它自己修。
其他工具也有固定的眉角:read 要能分頁(pi 用 offset/limit,預設 2000 行);bash 要截斷超長輸出、回傳 exit code;長時間執行的東西,丟給 tmux 讓人類也能進去看。
最痛的一層:各家模型的 API 方言
如果你只接一家模型,這段可以跳過。但只要想支援第二家,就會開始懷疑人生。
Zechner 說 pi-ai 只需要對接四種 API:OpenAI Chat Completions、OpenAI Responses、Anthropic Messages、Google Generative AI。聽起來不多,問題在 Chat Completions 被一堆廠商和本地推論引擎各自實作,方言多到靠北:
| 狀況 | 哪些供應商 |
|---|---|
不接受 store 欄位 |
Cerebras、xAI、Mistral、Chutes |
用 max_tokens 而不是 max_completion_tokens |
Mistral、Chutes |
不支援 developer role |
Cerebras、xAI、Mistral、Chutes |
拒絕 reasoning_effort |
Grok 系列 |
| reasoning 內容放在不同欄位 | reasoning_content 或 reasoning |
| token 用量回報時機不一 | 有的在串流開頭,有的在結尾 |
還有更麻煩的:跨供應商交接 context。Anthropic 的 thinking trace 轉給 OpenAI 時,pi 會改寫成 <thinking> 標籤包住的文字;各家回傳的簽章 blob 也必須原封不動地在後續請求送回去。作者最後連 Vercel AI SDK 都不用,直接用各家官方 SDK 自己包,就是為了拿回完整控制權。
我的建議很實際:這層不要自己重寫。想用 TypeScript 的話,直接拿 pi-ai 當底層,你省下的時間足夠去做真正有差異化的東西。
Session 樹與 compaction:長對話不爆的關鍵
對話一長,context 一定會滿。這是 harness 第二難的地方,pi 的做法我覺得是目前開源界寫得最清楚的。
Session 用 JSONL 樹存(Shilin 的〈Inside Pi Agent〉 把這段拆得很細)。每筆紀錄帶 id 和 parentId,存在 ~/.pi/agent/sessions/ 底下。目前的對話,就是「從根節點走到某個葉節點」的那條路徑。用 /tree 跳回之前的某一句重新來過,會長出一條新的兄弟分支,舊內容不會被刪;離開某條分支時,還可以替它寫一份摘要。
Compaction 有明確的參數(出自官方 compaction 文件 ):
| 項目 | 預設值 | 意義 |
|---|---|---|
| 觸發條件 | contextTokens > contextWindow - reserveTokens |
128k 視窗大約在 111,616 tokens 時觸發 |
reserveTokens |
16384 | 留給模型回覆的空間 |
keepRecentTokens |
20000 | 最近這麼多 tokens 原封保留 |
| token 估算 | 字元數 ÷ 4 | 以最近一次 API 回報的實際用量為錨點,只估算之後新增的訊息 |
流程大概長這樣:
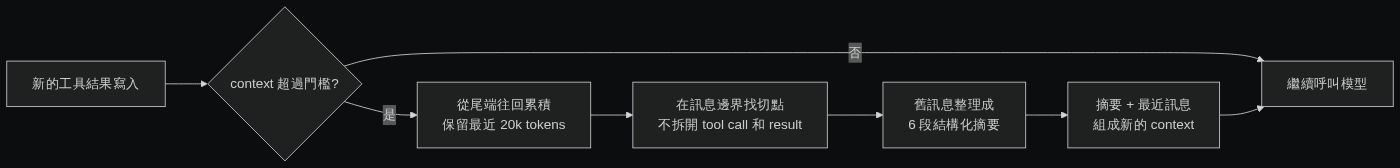
摘要固定分六段:目標、限制與偏好、進度(完成/進行中/卡住)、關鍵決策、下一步、關鍵 context,後面再附上讀過和改過的檔案清單。第二次壓縮時,會把舊摘要放進 <previous-summary> 標籤,再把新進度合併進去,而不是從頭重寫。
不過要提醒一句:compaction 不是萬靈丹。Anthropic 在 Effective harnesses for long-running agents 裡提到,光靠 compaction,連 Opus 4.5 都做不完正式品質的應用程式;他們最後改用「初始化 agent 加上反覆被喚醒的 coding agent」,靠交接檔案串起每一輪。到了後來的模型世代,單一長 session 加上自動 compaction 又變得夠用了。harness 要跟著模型世代一起調整,沒有一勞永逸這回事。
介面與擴充:pi 最有個性的地方
TUI 的設計很值得抄,但 pi 自己在這裡轉了個彎。 作者 2025 年的文章說,pi-tui 是「捲動紀錄型」,跟 Claude Code、Codex 同一派,保留終端機原生的捲動和搜尋。每個元件實作 render(width),回傳一串帶顏色的文字行。差分渲染的規則很樸素:找到第一行跟畫面上不一樣的地方,從那裡重畫到底;寬度變了就整個清掉重畫。每次更新再用 CSI ?2026h / CSI ?2026l 包起來,終端機就會一次把整個畫面換掉,閃爍幾乎消失。
到了 Pi 1.0,changelog 寫明預設改成全螢幕模式,想要原本的捲動紀錄行為,得在設定裡把 tuiMode 改成 "regular",或啟動時加 --tui-mode regular。Hacker News 上對這個改動吵得很兇:有人說全螢幕終於治好了閃爍,也有人覺得 agent 就該是單純的 CLI。兩種做法各有代價,自己做的時候選一種就好,不用糾結。
如果你懶得做 TUI,我真心建議先做 print 和 JSON 模式。好測試、好寫進 CI,pi 自己也有這兩種模式,外加 RPC 和 SDK。
擴充性取代內建功能,這是 pi 最有個性的地方。它刻意不做子代理、權限確認彈窗、plan mode、待辦清單、背景 bash,改成讓你用 TypeScript extension 自己加,或是直接叫 pi 幫你寫一個 extension,然後熱重載。Extension 可以掛在輸入、context、模型請求、session、工具的生命週期上;在工具執行前加一個 hook,就能自己做核准流程或沙箱。
Skills 走漸進揭露:系統提示裡只放技能目錄(名稱、描述、路徑),模型需要時才去讀完整的 SKILL.md。這樣系統提示永遠很短,prompt cache 也一直命中。
最後有個很有意思的轉折。Zechner 在 2025 年那篇文章 裡拒絕支援 MCP,理由是 Playwright MCP 有 21 個工具、約 13.7k tokens,Chrome DevTools MCP 有 26 個工具、約 18k tokens,一接上就吃掉 7–9% 的 context。但 2026 年 9 月 29 日,Earendil 發了一篇 “You Said No MCP!” ,接著 10 月 1 日發布的 Pi 1.0 就把 MCP 放進核心,還多了 Codemode:讓 agent 在 harness 端的 JavaScript 沙箱裡組合多個工具呼叫,結果存在 session 裡,不必全部塞進 context。Earendil 在文章裡的說法是,現在的 MCP 已經不是當年那個 MCP,更接近 OpenAPI;加上新模型支援延遲載入工具,Pi 這邊也改得動了。
連「不做 MCP」這麼鮮明的立場都會隨模型進步而改,這件事本身就是最好的 harness 設計課。
踩坑紀錄
坑一:把 tool call 和 tool result 拆散。 自己寫 compaction 時,最常見的 bug 是切點剛好落在兩者中間,下一次呼叫 API 直接收到錯誤,Anthropic 的錯誤訊息大意是某個 tool_result 找不到對應的 tool_use。解法就是 pi 的規則:切點只能落在訊息邊界,tool call 和它的 result 永遠綁在一起。
坑二:用通用的逐行讀取器讀 JSONL。 pi 的 RPC 文件 和 README 特別警告:RPC 模式不要用 Node 的 readline 這類通用工具切行,它們也會在 JSON 內容裡的 Unicode 分隔字元處切開,訊息就被切爛了。請自己只用 \n 切。
坑三:max_tokens 用完被截斷。 模型寫到一半遇到 stop_reason: "max_tokens",tool call 的 JSON 就是不完整的。pi 的做法是遇到 context overflow 或提早因為長度停止時,先壓縮再重試一次;最小版至少要把這種情況印出來,不要當成正常結束。
坑四:YOLO 模式直接跑在本機。 pi 預設沒有權限系統,作者的理由是「能讀資料、能執行程式、能連網的 agent 本來就沒辦法真正安全」。這很誠實,但你的家目錄可不會因為誠實就比較安全,夭壽危險。
官方 containerization 文件 列了四種隔離方式:
| 方式 | 優點 | 代價 |
|---|---|---|
| 純 Docker | 最簡單 | 掛載的目錄會直接寫回本機;金鑰放在環境變數裡,容器內看得到 |
| Docker Sandboxes | 用 proxy 換掉金鑰,真正的金鑰不進沙箱 | 依賴 Docker 的 sandbox 工具 |
| OpenShell | 可以用政策控制檔案、行程、網路、憑證 | 需要額外的 gateway |
| Gondolin extension | pi 留在本機,只有工具跑在 micro-VM 裡 | 環境變數裡的金鑰仍可能外洩 |
自己做 harness 的話,最低限度是用 Docker 跑、只掛載工作目錄,再在工具 hook 裡把 rm -rf、git push、curl | sh 這類指令列入二次確認。
我的建議路線
看到這裡你可能會想:所以到底要自己寫,還是直接用 pi?我的答案是看目標:
| 你的目標 | 建議做法 | 預估時間 |
|---|---|---|
| 搞懂 agent 原理 | 照上面的 300 行版本寫一次,再對照 pi 原始碼,依序加上工具品質、session、compaction | 1–2 週 |
| 要一個每天用的工具 | 直接用 pi,用 extension 和 skills 客製成自己的工作流 | 1 天上手 |
| 做自己的產品或嵌入式 agent | 底層用 pi-ai + pi-agent-core,自己寫工具、UI 和領域知識 |
依需求 |
不管走哪一條,有一件事我覺得不能省:先準備一份自己的評測任務。挑 10 到 30 個你真的會遇到的任務,每個都附自動檢查,然後固定模型、只改 harness 做比較。不然你根本不知道剛剛那個改動是變好還是變壞,只是在憑感覺調參,跟 vibe coding 沒兩樣。
回到開頭那個 69.7% 到 77.0%:模型會一直進步,但讓它在你的 repo、你的工具、你的工作流裡發揮到極限的,是你自己的 agent harness。現在就開一個資料夾,把 mini_agent.py 存進去跑一次吧。跑起來之後,你就再也不會覺得 coding agent 是黑盒子了。
常見問題
pi 跟 Claude Code 差在哪?
pi 的核心刻意做得很小:預設只有 read、write、edit、bash 四個工具,系統提示加工具定義在 2025 年版本不到 1000 tokens。它不內建子代理、權限確認和 plan mode,需要時用 TypeScript extension 自己加。Claude Code 功能完整、開箱即用,但可以客製的地方少,送給模型的 context 也大得多。
自己寫一個 agent harness 要花多久?
最小可用的迴圈大約 300 行,一個下午就能跑起來。要做到好用的工具錯誤訊息、session 持久化和 context 壓縮,依經驗大約需要一到兩週。
一定要用 TypeScript 嗎?
不用。agent harness 的原理用任何語言都能實作,文中的最小範例就是 Python。如果想直接沿用 pi-ai、pi-agent-core 這些現成套件,才需要用 TypeScript。
pi 現在支援 MCP 嗎?
支援。2026 年 10 月 1 日發布的 Pi 1.0 把 MCP 放進核心,並推出 Codemode,讓 agent 在 JavaScript 沙箱裡組合多個工具呼叫。2025 年的版本不支援 MCP。
讓 coding agent 直接在本機執行安全嗎?
pi 預設沒有權限系統,會用你的使用者權限直接執行指令。建議至少用 Docker 執行、只掛載工作目錄,並對 rm -rf、git push 這類指令加上二次確認。
參考資料
- What I learned building an opinionated and minimal coding agent — Mario Zechner
- Pi 官網
- “You Said No MCP!” — Earendil
- earendil-works/pi(GitHub)
- pi compaction 文件
- Pi coding-agent CHANGELOG(1.0.0)
- pi containerization 文件
- I Hated Every Coding Agent, So I Built My Own — Mario Zechner(Mastra)
- How to Build an Agent — Thorsten Ball
- Effective harnesses for long-running agents — Anthropic
- Stop Comparing LLM Agents Without Disclosing the Harness(arXiv 2605.23950)
- Inside Pi Agent — Shilin's Blog



沒有留言:
張貼留言