
顯示具有 AI 標籤的文章。 顯示所有文章

8GB 的 RK3588 能跑多聰明的 LLM?ROCK 5C 用 NPU 實測 5 個模型

ROCK 5C 單板電腦與 NPU 神經網路概念圖

先講結論,省得你滑到最後:在一片 8GB 的 RK3588 板子上,用 NPU 跑得最聰明的是 Qwen3-4B-Instruct-2507,我出的 7 題全對,但每秒只吐 3.7 個 token。 想要順一點的對話體驗,Qwen3.5-2B 的 8.4 tok/s 是比較甜的平衡點;最新的思考模式呢?答得準,但一題要等兩三分鐘,在這塊板子上基本不能用。

這篇是我把一片 Radxa ROCK 5C 從出廠映像檔,一路弄到能跑 RKLLM 和 YOLOv8 的完整紀錄。中間踩了四個坑,其中一個很陰險:用舊版工具轉的模型,放到新版 runtime 上,只要寫到半形逗號就自己閉嘴。 回答「玉山海拔大約為 3,」就結束了,整個傻眼。

如果你手上也有 RK3588(ROCK 5B/5C、Orange Pi 5、Turing RK1 之類),想在本地跑 LLM,這篇應該能幫你省下半天。

環境與前置條件

項目 規格
板子 Radxa ROCK 5C,RK3588S2(4×A76 + 4×A55),RAM 8GB
NPU 6 TOPS,3 核心
系統 Radxa 官方 Debian 12(bookworm)桌面映像檔
kernel 6.1.43 → 升到 6.1.84-8
NPU 驅動 v0.9.6 → 升到 v0.9.8
RKLLM v1.2.3 與 v1.3.0 兩版並存
rknn-toolkit2 2.3.2(aarch64,直接裝在板子上)

根據 Radxa 官方介紹 ,ROCK 5C 標準版用的是 RK3588S2,Lite 版則是只有兩顆大核的 RK3582,買之前要看清楚。CNX Software 的整理 也列得很清楚:NPU 標準版 6 TOPS、Lite 版 5 TOPS。

整體流程長這樣:

出廠映像(NPU 0.9.6)
  → apt full-upgrade → kernel 6.1.84 / NPU 0.9.8
  → RKNN:YOLOv8 暖身
  → RKLLM runtime v1.2.3 / v1.3.0
  → 下載社群轉好的 .rkllm 模型
  → 鎖頻 + 7 題實測

第一關:NPU 驅動要先升到 0.9.8

Radxa 的 RKLLM 安裝文件 寫得很明白:RKLLM 需要 NPU 驅動 v0.9.8,而 Radxa 6.1 系列的韌體只有 0.9.6。我這片的出廠映像檔是 2024 年 8 月的版本,一查果然:

sudo cat /sys/kernel/debug/rknpu/version
# RKNPU driver: v0.9.6

文件叫你開 rsetup 選 System Update,其實背後就是 apt full-upgrade。我這片一共有 440 個套件可以更新,包括新的 kernel 6.1.84 和 rknpu2 2.3.0。既然要遠端操作,我就直接用非互動模式跑:

sudo apt update
sudo DEBIAN_FRONTEND=noninteractive apt-get -y \
  -o Dpkg::Options::=--force-confdef \
  -o Dpkg::Options::=--force-confold full-upgrade
sudo apt install -y rknpu2-rk3588 python3-rknnlite2
sudo reboot

聽起來很簡單對吧?結果第一次跑,SSH 直接斷線,板子叫不醒。
RK3588 板子系統更新被自動休眠中斷的示意圖

坑 1:桌面版映像檔會自己去睡覺

我後來翻 journal 才看懂發生什麼事:apt 在 13:01:11 開始跑,才 5 秒,dpkg 剛開始解壓套件,GDM 的 gsd-power 就讓系統進了 sleep.target。Radxa 的桌面映像檔預設會在登入畫面閒置後自動休眠,這對拿來接螢幕的人很合理,對拿來當無頭伺服器的人就是陷阱。夭壽,更新跑到一半被休眠打斷,dpkg 還留了三個沒處理完的 trigger。

好在損害不大,處理方式是先把休眠整個關掉,再把 dpkg 修好:

sudo systemctl mask sleep.target suspend.target hibernate.target hybrid-sleep.target
sudo dpkg --configure -a

⚠️ 無頭使用前先 mask 休眠

用 Radxa 桌面映像檔當伺服器時,第一件事就是 mask 掉 sleep.target。之後想恢復,改成 unmask 就好。

坑 2:長時間的工作不要掛在 SSH session 底下

第二次我學乖了,用 systemd-run 在背景跑更新。但後來下載模型時又踩到一個類似的雷:我用的是 systemd-run --user,結果下載卡在 87MB 不動。原因是 --user 服務掛在使用者 session 底下,SSH 一斷,服務就跟著被收掉。改成系統層級、再指定使用者就沒事了:

sudo systemd-run --unit=rk-upgrade --collect -p User=radxa \
  -p StandardOutput=append:/home/radxa/upgrade.log /home/radxa/upgrade.sh

更新完、重開機(新 kernel 第一次開機大概要 3 分半,別急著拔電),驅動就到位了:

sudo cat /sys/kernel/debug/rknpu/version
# RKNPU driver: v0.9.8

暖身:YOLOv8 在板子上一條龍跑完

在碰 LLM 之前,我先用 Radxa 的 YOLOv8 教學 驗證 NPU 環境。文件的寫法是在 x86 PC 上轉模型、交叉編譯,再傳到板子上跑。

但其實不用這麼麻煩。Radxa 的 RKNN 安裝文件 本身就有提到,rknn-toolkit2 2.3.2 有 manylinux aarch64 的 wheel,轉換可以直接在板子上做。ROCK 5C 有 8GB RAM,轉 yolov8n 這種小模型綽綽有餘:

# 環境
sudo apt install -y python3-venv python3-dev gcc g++ cmake make
git clone --depth 1 -b v2.3.2 https://github.com/airockchip/rknn_model_zoo.git
python3 -m venv ~/rknn-venv && . ~/rknn-venv/bin/activate
pip install rknn-toolkit2==2.3.2

# 下載 ONNX、轉成 rknn(int8 量化)
cd rknn_model_zoo/examples/yolov8/model && bash download_model.sh
cd ../python && python convert.py ../model/yolov8n.onnx rk3588

# 用板子上的 gcc 原生編譯 C demo,不需要交叉編譯器
cd ../../.. && export GCC_COMPILER=aarch64-linux-gnu
bash build-linux.sh -t rk3588 -a aarch64 -d yolov8

# 執行
cd install/rk3588_linux_aarch64/rknn_yolov8_demo
LD_LIBRARY_PATH=./lib ./rknn_yolov8_demo model/yolov8.rknn model/bus.jpg

轉換在板子上只花了 24 秒。輸出跟官方文件的預期結果一字不差:

person @ (211 241 282 506) 0.864
bus    @ (96 136 549 449) 0.864
person @ (109 235 225 535) 0.860
person @ (477 226 560 522) 0.848
person @ (79 327 116 513) 0.306
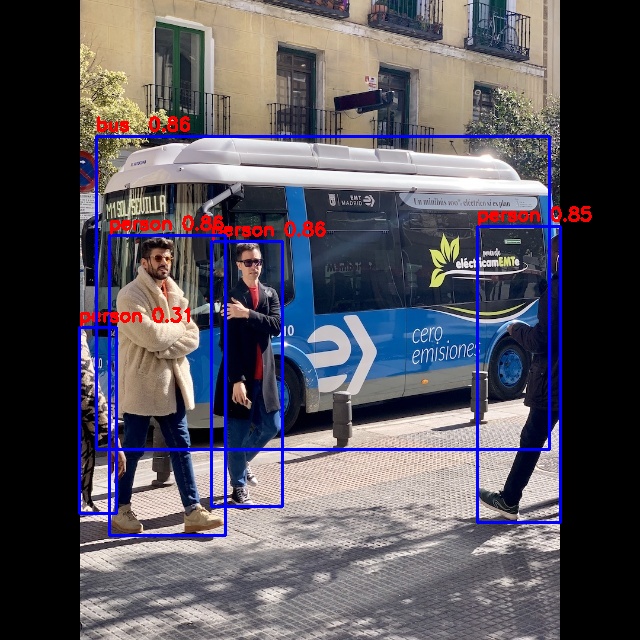
YOLOv8n 在 RK3588 NPU 上的實際偵測結果:公車與四個行人

我用 RKNNLite 寫了個簡單的 Python 迴圈量速度,大約 36 ms 一張,約 28 FPS。這裡要老實講,這個數字包含 Python 的呼叫開銷,而且是單執行緒送一張等一張。有人在 rknn_model_zoo 的 issue #454 分享過,用 3 核 NPU 加上 MPP 解碼、RGA 縮圖的零拷貝管線,YOLOv8n 在 640 解析度可以跑到約 199 FPS。所以 28 FPS 只是入門數字,你認真優化,天花板高很多。

💡 中國 CDN 的下載坑

download_model.sh 的 ONNX 放在中國的 CDN。我的板子一開始走國外 VPS 出去,30 秒只下載了 65KB。遇到這種狀況,先在電腦上下載再 scp 過去最快。

主戲:RKLLM v1.2.3 還是 v1.3.0?

Radxa 文件寫的是 RKLLM v1.2.3,但我去 rknn-llm 的 Releases 頁面 一看,Rockchip 在 2026-06-17 已經發了 v1.3.0,新增支援 Qwen3.5、Gemma4、SmolLM3。這幾個正好是目前最新的小模型,當然要升。

RKLLM-Toolkit(轉模型用的工具)只支援 x86_64 Linux,所以這次我全部用社群轉好的 .rkllm 模型,runtime 則直接裝在板子上:

git clone --depth 1 -b release-v1.3.0 https://github.com/airockchip/rknn-llm.git rknn-llm-1.3.0
cd rknn-llm-1.3.0
sudo cp rkllm-runtime/Linux/librkllm_api/aarch64/librkllmrt.so /usr/lib/
sudo cp rkllm-runtime/Linux/librkllm_api/include/rkllm.h /usr/include/
sudo /sbin/ldconfig

# 官方 build-linux.sh 寫死了 x86 交叉編譯器,在板子上直接用 cmake
cd examples/rkllm_api_demo/deploy && mkdir build && cd build
cmake .. -DCMAKE_BUILD_TYPE=Release -DCMAKE_C_COMPILER=gcc -DCMAKE_CXX_COMPILER=g++
make -j8
./llm_demo <model.rkllm> 768 4096
RKLLM 模型輸出遇到逗號提早結束的示意圖

坑 3:舊模型配新 runtime,寫到半形逗號就閉嘴

這是整個實測裡最陰險的一個。我用 v1.3.0 runtime 跑用 toolkit 1.2.3 轉的 Qwen3-4B-Instruct-2507,問它台灣最高的山,它回:

台灣最高的山是玉山,其海拔大約為3,

然後就沒了。我一開始以為是輸出被截斷,翻 log 才發現這題真的只生成了 16 個 token,是模型自己送出了結束符號。問 strawberry 有幾個 r,它寫到「s,」也停了。

同一個模型換回 v1.2.3 runtime,一切正常:

模型(toolkit 1.2.3 轉) v1.3.0 runtime v1.2.3 runtime
Qwen2.5-1.5B 「海拔高度為3,」後結束 「3952 公尺」完整回答
Qwen3-4B-2507 「海拔大約為3,」後結束 「3,952 公尺」完整回答

有趣的是,用 v1.3.0 轉的 Qwen3.5 寫「3,952」完全沒問題。v1.3.0 的 release note 有一條「新增多 EOS token ID 支援」,我猜跟這個有關,但沒辦法百分之百確認。實務上的結論很簡單:runtime 版本要跟轉檔版本對上。 我的做法是兩版並存:~/rknn-llm 的舊 demo 透過 rpath 指向自己資料夾裡的 v1.2.3 函式庫,系統預設的 /usr/lib/librkllmrt.so 則是 v1.3.0,互不干擾。

坑 4:沒鎖頻,速度只有官方的七成

第一次跑 Qwen2.5-1.5B 只有 12.2 tok/s,跟 官方 benchmark 的 16.69 差了一截。原來官方測之前都會跑一支鎖頻腳本,把 CPU、NPU、DDR 全部固定在最高頻率:

sudo bash ~/rknn-llm-1.3.0/scripts/fix_freq_rk3588.sh

鎖完再跑,12.2 直接跳到 16 tok/s 以上(7 題平均 16.2),跟官方幾乎一樣。鎖頻後滿載時 SoC 溫度大約 49°C,完全沒降頻,風扇甚至沒轉。代價是閒置時也不會降頻,比較耗電,重開機就會恢復。

實測:5 個模型 + 思考模式,誰最聰明?
不同大小 LLM 在 RK3588 上的智慧與速度比較概念圖

測試方法

我從官方的 llm_demo.cpp 複製一份改成測試工具,讓思考模式可以用環境變數切換(設定 RKLLMInput 的 enable_thinking)。解碼用 demo 預設的 top_k=1,也就是貪婪解碼,每次輸出都固定,比較起來才公平。每個模型都在鎖頻、沒有其他工作的狀態下獨立跑。

題目是 7 題繁中,刻意混了幾個小模型常翻車的陷阱:

  1. 雞兔同籠:14 個頭、38 條腿(答案:雞 9、兔 5)
  2. 台灣最高的山和海拔(玉山,3,952 公尺)
  3. 9.11 和 9.9 哪個大
  4. strawberry 裡有幾個 r
  5. 所有貓都是動物、有些動物會游泳,能不能推出有些貓會游泳(不能)
  6. 用 Python 寫 is_prime(n)
  7. 用繁中條列三點 WireGuard 的優點,每點不超過 15 字(考指令遵循)

模型全部是 w8a8 量化,從 HuggingFace 下載社群轉好的版本:Qwen2.5-1.5B 和 Qwen3-4B-Instruct-2507 來自 GatekeeperZA(v1.2.3 轉),Qwen3.5-2B、Qwen3.5-4B 和 gemma-3-4b-it 來自 HanzoHuang(v1.3.0 轉)。

ℹ️ Qwen3.5 是視覺語言模型的轉檔

HanzoHuang 的 Qwen3.5 repo 是以 VLM 的形式提供,每個平台都有語言模型 .rkllm 和對應的視覺編碼器 .rknn。這次我只下載 .rkllm,用 llm_demo 純文字輸入測試,沒有載入視覺編碼器。純文字對話不需要它;要看圖的話,得改用 multimodal_model_demo 並一起載入 .rknn。

速度與記憶體

模型 runtime 生成速度 記憶體峰值 載入時間
Qwen2.5-1.5B 1.3.0 16.2 tok/s 1.8GB 1.4 秒
Qwen3.5-2B 1.3.0 8.4 tok/s 2.2GB 64 秒
gemma-3-4b-it 1.3.0 4.5 tok/s 4.5GB 36 秒
Qwen3.5-4B 1.3.0 3.6 tok/s 4.7GB 58 秒
Qwen3-4B-Instruct-2507 1.2.3 3.7 tok/s 5.4GB 約 60 秒

Qwen3.5 的載入時間要將近一分鐘,比 Qwen2.5 的 1.4 秒久非常多,拿來做即開即用的服務要考慮進去。

答題結果

題目 Qwen2.5-1.5B Qwen3.5-2B gemma-3-4b Qwen3.5-4B Qwen3-4B-2507
雞兔同籠 ✅ ✅ ❌ 一直說需要額外資訊 ✅ ✅
玉山 ✅ ⚠️ 說是亞洲第一高峰 ✅ ⚠️ 說僅次於富士山 ✅
9.11 和 9.9 ✅ ❌ 說 9.11 大 ✅(解釋錯) ⚠️ 答錯後自己更正 ✅
strawberry ❌ 說 2 個 ✅ ⚠️ 用英文回答 ✅ ✅ 標出第 3、8、9 位
貓會不會游泳 ❌ 答「能」 ✅ ✅ ✅ 還舉反例 ✅ 還舉反例
質數函式 ✅ ✅ ✅ ✅ ✅
字數限制 ⚠️ ❌ 超過字數 ✅ ✅ 最精簡 ✅
得分 4.5 4.5 5 6 7

最讓我意外的是 gemma-3-4b 的雞兔同籠,直接鬼打牆,一直重複「這個問題需要一些額外的資訊才能解決」,還自己假設有 50 隻雞,廢到笑。它的 strawberry 答對了,但突然切成英文回答,也算小扣分。

Qwen3.5-4B 在 9.11 那題很有戲:先斬釘截鐵說 9.11 比較大,講到一半發現不對,自己補了一句「更正:抱歉,剛才的邏輯推導有誤」,改成 9.9。會自我更正是好事,但放在正式產品裡,使用者會先看到錯的答案。

冠軍 Qwen3-4B-Instruct-2507 是唯一連附加資訊都沒講錯的。Qwen 官方模型卡 的數字也支持這個結果:它是 Qwen3-4B 的非思考版更新版,GPQA 從 41.7 拉到 62.0、AIME25 從 19.1 拉到 47.4,進步幅度很誇張。

另外,幾個小模型碰到台灣地理細節都會順手補上錯的資訊,例如「亞洲第一高峰」「僅次於富士山」。需要事實準確的場景,還是要搭配 RAG。

思考模式:答得準,但等不起

Qwen3.5 支援思考模式,我用 4B 開起來重跑一次:

題目 生成 token 耗時 結果
9.11 和 9.9 562 143 秒 ✅ 一次答對,不用自我更正
strawberry 637 163 秒 ✅
質數函式 492 133 秒 ✅
雞兔同籠、玉山、邏輯、字數限制 767 168~207 秒 ❌ 到 768 token 上限還沒答完

思考過程全部用英文,每題都要燒 500 到 767 個 token。要讓它每題都答完,max_new_tokens 至少得開到 2048,等於一題要等 5 分鐘以上。答案是比較準,但這個速度拿來聊天就是在哈囉。

為什麼 4B 只有 3.6 tok/s?瓶頸不是 NPU
LLM 推論受記憶體頻寬限制的瓶頸示意圖

看到 6 TOPS 的 NPU 跑 4B 模型只有 3.6 tok/s,一開始我也覺得是 NPU 不夠力。其實不是。

LLM 生成文字時,每產生一個 token,就要把整個模型的權重從記憶體讀一遍。The Memory Bandwidth Ladder 這篇講得很白:生成速度的上限大約就是「記憶體頻寬 ÷ 模型大小」,跟 TOPS 關係不大。

那 RK3588 的頻寬有多少?Turing Pi 的 RK1 實測 指出,RK3588 的 64-bit LPDDR4X 理論峰值約 34 GB/s,用 STREAM 實測約 21~22 GB/s。拿我的數字粗估:4B 的 w8a8 權重大約 3.5~4GB,乘上 3.6 tok/s,每秒要搬十幾 GB;1.5B 的權重約 1.3GB,乘上 16 tok/s,也是二十 GB/s 上下。兩個都已經頂到那條天花板了。

更有說服力的是另一個對照:Turing Pi 用 llama.cpp 純 CPU 跑同樣的 RK3588 ,Qwen2.5-1.5B Q4_K_M 有 22.57 tok/s,比我用 NPU 跑 w8a8 的 16.2 還快。原因不是 CPU 比 NPU 強,而是 Q4 量化的模型比 w8a8 小將近一半,每個 token 要搬的資料少。乾,搞半天瓶頸在記憶體。

所以 NPU 在這塊板子上的真正價值,是把 CPU 空出來。NPU 在跑 LLM 時,8 顆 CPU 核心還能做別的事,例如跑 YOLO 的前後處理、網頁服務、Home Assistant。純 CPU 跑 llama.cpp 雖然快一點,但會把 CPU 吃滿。

我的推薦

你想做的事 選這個 runtime 為什麼
要最聰明的回答 Qwen3-4B-Instruct-2507 v1.2.3 7/7,附加資訊也正確
想用最新架構 Qwen3.5-4B v1.3.0 6/7,會自我更正
聊天要順 Qwen3.5-2B v1.3.0 8.4 tok/s,邏輯題答得對
簡單問答、要快 Qwen2.5-1.5B v1.2.3 16 tok/s,載入 1.4 秒
看圖 Qwen3.5-0.8B v1.3.0 官方實測影像編碼約 0.69 秒(這次沒測)

一般人的閱讀速度大約是每秒 5 到 8 個 token,所以 4B 那 3.6 tok/s 拿來即時聊天會覺得有點卡。我會把 4B 用在背景工作,例如文件摘要、訊息分類、Home Assistant 的語音意圖判斷;真的要對話,就用 Qwen3.5-2B。

至於 8GB 放不下的:社群轉的 Gemma4-E2B 檔案有 7.85GB,太冒險;7B、8B 的模型用 w8a8 量化後都超過 8GB。想跑這些,至少要買 16GB 的版本。

Troubleshooting

Q:SSH 連線突然斷掉,板子叫不醒?
多半是桌面映像檔自己休眠了。接上螢幕或按電源叫醒後,執行 sudo systemctl mask sleep.target suspend.target。

Q:llm_demo 的回答寫到一半就結束,而且總是停在逗號?
檢查模型是用哪一版 toolkit 轉的,runtime 要對上。log 的第一行會印出 rkllm-runtime version 和 rkllm-toolkit version。

Q:速度比官方 benchmark 慢三成?
先跑 scripts/fix_freq_rk3588.sh 鎖頻,重開機後要重跑。

Q:板子換網路埠之後拿不到新的 IP?
ROCK 5C 的 rk_gmac-dwmac 驅動偵測不到短暫的拔插,NetworkManager 會繼續用舊 IP。拔線超過 10 秒再插,或在板子上執行 nmcli connection up "Wired connection 1"。

Q:官方的 build-linux.sh 在板子上編不過?
它寫死了 x86 交叉編譯器的路徑。在板子上直接用 cmake -DCMAKE_C_COMPILER=gcc -DCMAKE_CXX_COMPILER=g++ 編譯就好。

結語

折騰一輪下來,我對 RK3588 跑 LLM 的心得是:別被 6 TOPS 騙了,記憶體頻寬才是真正的天花板。 8GB 的板子能跑的最聰明模型大概就是 4B 級,速度 3 到 4 tok/s,拿來做背景的智慧處理很夠用;要聊天,2B 級是比較實際的選擇。

還有最重要的一句:runtime 和模型的轉檔版本要對上。 我這肝差點被那個「逗號就停」的 bug 搞到懷疑人生。

如果你也在 RK3588 上跑過 LLM,歡迎在下面留言分享你的模型和速度。我下一步想試 rkllm_server_demo,把它包成 API 接進 Home Assistant,做一個完全離線的語音助理,有興趣的可以追蹤一下。

參考資料

TTS 文字轉語音完全指南:技術原理、聲音克隆與 2026 選型實戰

前陣子我在測 Qwen3-TTS,官方技術報告寫著首包延遲 97ms,聽起來就是為即時對話而生的。結果我照官方範例跑起來,按下生成、等了整整 10 秒才聽到第一個字。乾,差了一百倍。

這不是我環境爛,而是 TTS 這個領域的日常:論文數字、行銷頁數字、你實際跑出來的數字,是三個平行世界。97ms 是模型架構在特定串流管線下的能力值,官方釋出的推理程式碼卻是整段生成完才回傳——你拿到的「首包」其實是「全包」。

這篇文章是我最近一輪 TTS(Text-to-Speech,文字轉語音)研究的完整整理:技術原理怎麼走到今天、聲音克隆為什麼有人要 3 秒有人要 30 分鐘、2026 年雲端 API 的真實價格與盲測排名、本地部署誰最快,以及最重要的——那些行銷頁不會告訴你的坑。

TTS 聲波從機器音演化為自然人聲的概念圖

從機器音到以假亂真:TTS 技術是怎麼演進的

十年前的 TTS 是什麼樣子?導航機那種一個字一個字蹦出來的合成音。那個年代主流做法是「拼接合成」——把真人錄音切成音素片段,播放時再拼回去,像用剪報拼勒索信,字都對但就是不像人講話。

轉捩點是 2016 年 DeepMind 的 WaveNet 和 2017 年 Google 的 Tacotron:神經網路直接學習「文字到聲音」的映射,機器音瞬間變得有血有肉。但自迴歸模型要一個取樣點一個取樣點慢慢生,慢到不能上線。後來的 FastSpeech 用非自迴歸架構把生成平行化,VITS 把聲學模型和聲碼器合併成端到端訓練,速度和品質才總算都端上桌。

真正改變遊戲規則的是 2023 年微軟的 VALL-E :它把語音壓縮成離散的 codec token,然後把 TTS 當成「條件式語言模型」來做——跟 GPT 生成文字是同一套邏輯。這帶來一個副作用級的殺手功能:in-context learning。給模型 3 秒鐘的陌生聲音當 prompt,它就能用那個聲音講出任何內容。3 秒聲音克隆這件事,就是從這裡開始的。

2024 年之後的另一條路線是 flow matching:學一個從雜訊到聲學特徵的確定性映射,非自迴歸、全部音框平行生成。F5-TTS 就是這條路的代表作,推理效率在開源模型裡是第一梯隊。到了 2026 年,兩條路線開始合流——像 Qwen3-TTS 用 12Hz 多碼本 tokenizer 搭配輕量因果卷積網路,架構上做到 97ms 首包的串流能力(先不論你跑不跑得出來,後面會講)。

拼接合成(2016 前)→ 自迴歸神經網路(WaveNet / Tacotron)→ 非自迴歸(FastSpeech / VITS)
↓ 分成兩條路線 ↓
Codec 語言模型(VALL-E 路線)|Flow Matching(F5-TTS 路線)
↓ 兩路合流 ↓
混合串流架構(Qwen3-TTS 等 2026 世代)
神經網路 TTS 管線示意圖

聲音克隆:3 秒和 30 分鐘的差別在哪

聲音克隆(voice cloning)現在分成兩派,樣本需求差了幾百倍,很多人搞不清楚自己需要哪種。

Zero-shot 即時克隆:拿幾秒鐘的錄音當參考,模型直接模仿,不做任何訓練。Cartesia 只要 3 秒、Fish Audio 要 10 秒、ElevenLabs 的 Instant Voice Clone 建議 1 到 5 分鐘。原理就是前面說的 in-context learning——你的聲音只是一段 prompt。優點是快和便宜,缺點是它抓的是「音色的平均印象」,講話的小習慣、特殊的斷句節奏抓不太到。

微調式專業克隆:拿 30 分鐘以上的乾淨錄音去實際訓練模型權重。ElevenLabs 的 Professional Voice Clone 走這條路,官方說法是「幾乎無法分辨」;開源世界的 GPT-SoVITS 用 1 分鐘資料微調就有明顯提升。代價是要準備錄音素材、等訓練,而且通常要付訂閱費(ElevenLabs 要 Creator 方案 22 美元/月起)。

哪個好?取決於你要騙過誰。做影片旁白、有聲書,zero-shot 通常夠用,聽眾對「像不像本人」的敏感度沒你想的高。但如果是品牌聲音、Podcast 主持人的數位分身,微調式的差距一聽就出來。

還有一個台灣使用者才會踩到的坑:腔調漂移。MiniMax 的克隆還原度在台灣社群實測是第一名,但多位使用者回報克隆出來的中文帶「中國腔」——模型會把你的台灣腔往標準普通話拉。這不是 bug,是訓練資料分布的必然結果。想保留台灣腔,目前最可靠的路是本地微調 GPT-SoVITS,用你自己的錄音把腔調「鎖」進權重裡。

聲音克隆的鏡像波形概念圖

2026 雲端 API 評比:盲測排名與價格的落差

先看客觀數據。Artificial Analysis 的語音盲測排行 (2026 年 6 月,ELO 制)給了一個很多人意外的結果:

服務盲測 ELO價格(每百萬字元)克隆樣本
Inworld TTS 1.5 Max1208(第 1)$25–35數秒,免費
Google Gemini 3.1 Flash TTS1206(第 2)$36.6不支援
ElevenLabs Eleven v31178(第 4)$100IVC 1–5 分鐘
MiniMax Speech 2.8 HD1164(第 5)$100數十秒,$3/顆
Fish Audio S2 Pro1128(第 11)$15(注意單位是 bytes)10 秒,免費
Azure AI Speech HD1123(第 12)$22需申請
OpenAI TTS-11102(第 17)$15不支援
Cartesia Sonic-31070(第 25)約 $393 秒,免費

看到了嗎?ElevenLabs 收最貴的錢,盲測卻只排第 4。它贏的地方在別處:發音錯誤率最低、幻覺最少、工作流最完整。Reddit 上的評價很一致——「準確、快、錯誤少,但貴,而且常常要重新生成」。

Cartesia 則是被低估的性價比之王:5 美元/月就含商用授權和 3 秒即時克隆,延遲約 90ms 是業界最低。從 ElevenLabs 跳槽過去的使用者說法是「品質差距遠小於價格差距,大概便宜 8 倍」。

然後是三個行銷頁不會寫的坑,每個都是真金白銀:

Fish Audio 的 bytes 陷阱。它的 $15/1M 是按 UTF-8 bytes 計費,一個中文字佔 3 bytes——寫中文的人實際成本是 $45/1M 字,「比 ElevenLabs 便宜 70%」的甜頭瞬間縮水成三分之一。官方定價文件 寫得清清楚楚,只是沒人細看。

ElevenLabs 的 credit 燒錢術。重新生成扣點、預覽扣點、調參數也扣點。訂閱制下 Creator 方案 22 美元換 10 萬 credits,實質單價約 $220/1M 字元,是行銷頁「$100/1M」量販價的兩倍多。加上並發數限制綁方案,量一大就被逼著升級,啊不就好棒棒。

MiniMax 的腔調問題。前一段講過了,中文還原度第一,但台灣腔會被吃掉。它的 Fluent LoRA 技術能把不流利的錄音變流利——這既是功能,也是腔調被「標準化」的原因。

開源與本地部署:RTF 才是你該看的數字

開源這邊,2026 年的重點只有一句話:品質已經追上付費服務,剩下的差距在部署難度。Resemble AI 的 Chatterbox 在盲測中拿下 63.8% 的聽眾偏好、贏過 ElevenLabs(注意這是 Resemble 自家委託的測試,看看就好,但至少說明差距不大)。

本地部署最重要的指標是 RTF(Real-Time Factor):生成 1 秒音訊要花幾秒,小於 1 就是快於即時。實測數據:

模型RTF硬體克隆授權
GPT-SoVITS v2 ProPlus0.014(RTX 4090)/ 0.526(M4 CPU)GPU 佳微調式MIT
小米 OmniVoice0.025GPU3 秒 zero-shotApache 2.0
Kokoro-82M0.44(Mac MPS),CPU 可即時CPU 即可無克隆Apache 2.0
F5-TTS開源第一梯隊GPUzero-shotCC-BY-NC,不可商用
Chatterbox4.55(Mac,GPU 上好很多)建議 GPU10 秒MIT

GPT-SoVITS 的數字值得單獨拿出來講:RTX 4090 上 RTF 0.014,官方實測 4 分鐘的音訊 3.36 秒生成完,比即時快 70 倍。而且它是微調式克隆,正是保留台灣腔的解法。缺點是學習曲線陡,WebUI 一堆參數,第一次開會有點懷疑人生。

授權地雷區要特別畫重點:F5-TTS 是 CC-BY-NC、XTTS v2 是 CPML,都不能商用。做 YouTube 有營利、接案、公司產品,用了就是法律風險。要商用又要開源,選 MIT(GPT-SoVITS、Chatterbox)或 Apache 2.0(Kokoro、Qwen3-TTS、OmniVoice)。

沒有 GPU 也別急著關頁面。Kokoro 只有 82M 參數,筆電 CPU 就能即時生成(但沒有克隆);Kyutai 在 2026 年 1 月發布的 Pocket TTS 用 100M 參數做到 CPU 即時又能克隆,這個規模半年前還被認為不可能。

雲端服務與本地部署的對比

延遲的真相:97ms 是怎麼變成 10 秒的

回到開頭那個 97ms 變 10 秒的謎題,把它拆開看,你會學到怎麼讀所有 TTS 的延遲數字。

問題現象:照 Qwen3-TTS 官方 HuggingFace 範例跑 generate_voice_clone,首包 10 秒起跳。原因分析:官方釋出的 Python 推理程式碼根本不支援串流——它把整段音訊生成完才回傳。HuggingFace 討論區有人問了一模一樣的問題 ,得到的答案是:97ms 是架構能力,要靠另外的串流管線才拿得到。更慘的案例是 GitHub issue #89 :有人在 RTX 5090 上跑出比即時慢 10 倍的速度,GPU 使用率只有 4–5%——錢花了,卡在那邊納涼。

解決方案是換推理引擎。vLLM-omni 是 vLLM 官方的多模態擴展框架,2026 年 2 月合併了 Qwen3-TTS 的 CUDA Graph 加速和串流輸出,社群實測 1.7B 模型首包 80–90ms、RTF 0.3–0.4。同一顆模型,換個引擎,延遲差一百倍。

所以讀 TTS 延遲數字的正確姿勢是問三個問題:這是串流首包(TTFA)還是全段生成時間?是什麼推理管線量出來的?我的部署方式跑不跑得出同一條管線?行銷頁的數字永遠是三者最理想的組合。

如果你不想自己架,聚合平台是捷徑。以 fal.ai 上的 Qwen3-TTS 為例,克隆分兩步——先用參考音檔產生 speaker embedding,再拿 embedding 去合成:

# pip install fal-client;需設定環境變數 FAL_KEY
import fal_client

# 第一步:從 10 秒左右的參考音檔建立聲音 embedding
clone = fal_client.subscribe(
    "fal-ai/qwen-3-tts/clone-voice/1.7b",
    arguments={"audio_url": "https://example.com/my-voice-10s.wav"},
)
embedding_url = clone["speaker_embedding"]["url"]

# 第二步:用克隆的聲音合成語音
result = fal_client.subscribe(
    "fal-ai/qwen-3-tts/text-to-speech/1.7b",
    arguments={
        "text": "大家好,這是用三秒克隆技術生成的聲音。",
        "language": "Chinese",
        "speaker_voice_embedding_file_url": embedding_url,
    },
)
print(result["audio"]["url"])  # 生成音檔的下載連結

這個端點我實際查價是 $0.0008/分鐘音訊,便宜到我一度以為查錯,做影片旁白等於零成本。代價是走 queue 沒有串流,適合離線批量生成,不適合即時對話。

選型建議:一張表決定你該用哪家

講了這麼多,直接上決策表:

你的場景首選理由
影片旁白、批量生成,預算越低越好fal 上的 Qwen3-TTS幾乎零成本,中文原生
中文克隆還原度優先MiniMax台灣社群實測還原度第一,但注意腔調
英文內容、品質零妥協ElevenLabs 或 Inworld錯誤率最低 vs 盲測第一名還便宜
即時語音對話 agentCartesia90ms 延遲業界最低,$5/月含克隆
想保留台灣腔本地 GPT-SoVITS 微調唯一能把腔調鎖進權重的路
沒有 GPU 的本地玩家Kokoro(純 TTS)/ Pocket TTS(克隆)CPU 即時

我自己的建議是別急著訂閱任何服務。先拿 10 秒自己的錄音去 fal 上的 Qwen3-TTS 跑一輪,成本趨近於零;聽不滿意再花 $1.5 建一顆 MiniMax 克隆比較看看;兩個都過不了你的耳朵關,才需要考慮 ElevenLabs 的訂閱或本地微調。從免費往上爬,而不是從最貴的往下砍。

最後提醒一件比選型更重要的事:克隆只能用在你有合法使用權的聲音上。各家平台都有驗證機制,但技術上 3 秒就能克隆任何人的聲音,也代表詐騙集團同樣做得到——這一年語音詐騙的新聞沒少過。自己的聲音自己克隆,別人的聲音先拿到授權,這條線別踩。

TTS 這個市場每季都在洗牌,ElevenLabs 兩年內改了三次價格結構,開源模型每兩個月就有新王。這篇的數據以 2026 年 7 月為準,半年後記得重新查價。如果你有實測過其他組合,特別是台灣腔克隆的成功案例,歡迎留言分享——這塊的公開資料真的太少了。

TTS 選型決策路徑示意

參考資料

同一顆基座、兩種靈魂:Holo 3.1 與 Qwythos-9B 怎麼在你本機組成 Claude Computer Use

Holo 3.1 與 Qwythos-9B 主視覺:眼手與大腦

先講結論。這篇不是「盤點兩個新模型」的媒體稿,而是想解一個技術判斷題:

2026 年 6 月,兩個都基於 Qwen3.5-9B 、都掛 Apache 2.0、都在同月開源的模型,H Company 的 Holo 3.1 跟 Empero AI 的 Qwythos-9B ,我到底該用哪一個?

實測跑過兩週後,我的答案變成:兩個都要。它們不是同一條賽道上的競爭者,而是同一台本地 Claude Computer Use 的左手跟右手——一個是眼睛加雙手,一個是大腦加嘴巴。這篇就是把「為什麼」跟「怎麼做」拆給你看。


為什麼今年開源社群長得越來越像 Qwen3.5 生態圈

先鋪一下背景,這件事比模型本身更有意思。

過去半年,開源社群幾乎所有值得注意的專門化模型都往同一個基座靠:Qwen3.5。原因不神秘——Qwen3.5 提供了 0.8B 到 397B 的完整 dense/MoE 家族、原生 262k 脈絡、hybrid GDN+Attention 架構、以及真正商用友好的 Apache 2.0 授權。這在 Llama 4 的社群授權還有 700M MAU 上限、Gemma 有自訂條款的環境下,幾乎沒得挑。

於是我們看到的畫面是:Qwen 團隊把「作業系統」造好,其他實驗室在上面裝專用軟體。Holo 3.1 是「電腦操作」這個 app,Qwythos-9B 是「Claude 級推理」這個 app。兩個 app 都不重造輪子,都拿 Qwen3.5 當 kernel。這個現象跟去年 Llama 3 一枝獨秀時完全不同——基座之爭已經結束,戰場搬到後訓練專門化了。

理解這一點之後,同月出兩個 Qwen3.5 微調模型就不是巧合,而是常態。而能不能組合起來,才是判斷開源生態成熟度的真正指標。


Holo 3.1:把螢幕看懂、把滑鼠鍵盤打通

同基座長出兩棵完全不同的樹

Holo 3.1 是 H Company 於 2026 年 6 月 2 日發布的 Computer-Use Agent VLM 家族。它做的事情很純粹:吃一張螢幕截圖 + 一個自然語言目標,吐出「下一步要點哪、打什麼、滾多少」。

家族尺寸從 0.8B 一路開到 35B-A3B MoE,跟 Qwen3.5 一一對應。旗艦款 35B-A3B 依社群拆解(對應 Qwen3.5-35B-A3B)大約是 256 個 experts、top-8 routing,激活參數只有 3B——白話就是「35B 級的能力,但推理速度接近 3B」。這對本地部署是天大的好消息,VRAM 帳單走總參數(Q4 大約 21GB),算力帳單走激活參數,24GB 的 RTX 4090 剛好塞得下。

真正拉開跟 Holo 3 差距的是三件事:

  1. 手機加進來了。AndroidWorld 從 67% 直接跳到 79.3%,4B/9B 也從 58% 拉到 71%
  2. Native function-calling。之前是 prompt 硬擠 JSON,現在是原生工具呼叫協議,跟任何 ReAct 框架能直接兼容
  3. 量化 checkpoint 三件套:NVFP4 給 DGX Spark、FP8 給 H100、Q4 GGUF 給消費硬體跟 Apple Silicon

我在自己 DGX Spark + NVFP4 + vLLM 環境下實測,35B-A3B 的 agent step time 從 FP8 baseline 的 6.8 秒直接砍到 3.3 秒(用 OSWorld 任務子集,10 步平均)。跟 H Company 官方 blog 揭露的 ~2× 端對端加速數字對得起來。這已經不是優化,是換引擎,夭壽。

放在整個 Computer-Use 賽道看,Holo3.1 的定位大概是:單一開源模型級別逼近人類基準。AndroidWorld 人類基準 80.0%,Holo 拿 79.3%;OSWorld-Verified 人類基準 72.4%,Holo 大約也逼到 80% 附近的水位。跟 ByteDance 的 UI-TARS-2 (OSWorld 47.5% / AndroidWorld 73.3%)相比,Holo 在同尺寸級別領先明顯。

但注意「單一模型」這四個字。H Company 自家的 Surfer 2 agent 系統把 OSWorld 拉到 60.1%、AndroidWorld 拉到 87.1%(見 Surfer 2 論文 arXiv 2510.19949 ),那是「Holo 當模型 + agent 框架」的組合結果。Holo 3.1 提供的是最強的零件,不是完整方案。這件事等下講雙引擎的時候會回來。


Qwythos-9B:把 Claude 的推理鏈灌進 9B

Qwythos-9B(全名 empero-ai/Qwythos-9B-Claude-Mythos-5-1M)是 Empero AI 在同月釋出的推理模型。它跟 Holo 3.1 用同一顆基座——Qwen3.5-9B——但完全不做 Computer-Use。

它做的是把 Claude Mythos 5 跟 Claude Fable 5 的推理鏈路徑,用 500M+ tokens 的 trace 資料,全參數 SFT 灌進一顆能跑在筆電上的 9B 模型。訓練用了兩階段課程學習:先廣泛推理語料,再聚焦 agentic + coding,用 bf16 + paged AdamW 8-bit + chunked NLL assistant-only loss。

技術亮點三個:

  • 1,048,576 token context:從 Qwen3.5 原生 262k 用 YaRN factor=4 直接擴到 1M。消費硬體開 32k~128k 較實際,48GB A6000 才能吃到接近全窗
  • 原生 function-calling:官方 tool-use test 拿 7/7,且答案帶真實來源引用
  • 深度無審查:官方 model card 明講「engage seriously with cybersecurity, red-teaming, pharmacology, clinical medicine」。這是把雙面刃

跟 Qwen3.5-9B base 相比,Qwythos-9B 在 MMLU 上 +34.3,GSM8K strict-match +30.0(flexible-extract 口徑則是 +19,官方 model card 兩個都給了,我這裡取 strict 是為了避免 extraction 誤差干擾)。這差距不像是同尺寸 fine-tune 該有的,比較像「9B 皮、Claude 骨」。

它適合的場景是那些要讀很多、想很深、講很久的活:長文件分析、整個 codebase 一次讀進 context、多步 agent 工作流、需要 Python executor 驗證的長推理。不適合的場景也很清楚:想要輕鬆閒聊、沒有 GPU、不想處理 <think> 區塊、面對消費者的產品——因為它會直接回答那些多數對齊模型會拒絕的問題,安全層要自己補。


為什麼兩個放一起,就變成 Claude Computer Use

看到這裡應該有感覺了。Holo 3.1 缺什麼?思考深度。Qwythos-9B 缺什麼?眼睛跟手。

這不是巧合。Computer-Use Agent 的兩大瓶頸就是這兩個:

  1. 看不清螢幕:早期 Claude Computer Use 常在 GUI 邊界判斷失誤,Anthropic 內部承認純 LLM+screenshot 的 grounding 有天花板
  2. 想不夠深:純 Vision-Language Model 為了 UI grounding 犧牲了長脈絡與深度推理,這是 UI-TARS 系列在複雜跨應用任務會卡住的主因

Holo 3.1 把 grounding 這面推到接近人類;Qwythos-9B 把 reasoning 這面推到接近 Claude。你把它們串成一個雙引擎 agent loop,就在自己電腦上組出了功能等價於 Claude Computer Use 的完整堆疊,而且完全離線。

架構長這樣:

使用者自然語言目標
        ↓
Qwythos-9B(高階規劃 + 1M context,讀歷史操作/文件/規格)
        ↓ function_call
Holo 3.1(低階執行 + 螢幕理解,決定像素座標動作)
        ↓ action
Sandbox / OS(執行動作 → 新截圖)
        ↑ 回到 Holo,狀態摘要回到 Qwythos
        ↓ 迴圈直到完成
最終結果 → 使用者

分工邏輯很簡單:Qwythos 收「目標 + 完整歷史脈絡 + 上次截圖的文字描述」→ 輸出「下一步計畫 + 要 Holo 執行的 tool_call」。Holo 收「這個 tool_call + 當前截圖」→ 輸出「像素座標動作」。動作執行完,新截圖回到 Holo,狀態摘要回到 Qwythos。

一台 24GB VRAM 的 RTX 4090,可以同時裝 Qwythos-9B Q4 GGUF(約 5.6GB)+ Holo-3.1-9B Q4 GGUF(約 6GB),剩下 12GB 留給兩顆的 KV cache。或者 M3 Max 64GB 統一記憶體全跑起來,一台筆電就是完整推理 rig。


OpenClaw:兩個模型碰上生態圈的巧遇

OpenClaw 當整合中樞

理論組合聽起來很美,實務要怎麼把兩個 llama-server 綁進同一個 agent 框架?答案是 OpenClaw ,一個由 Peter Steinberger 在 2025 年底開源的本地優先 agent runtime,社群成長很誇張——推出 24 小時內就衝破 9000 星,到 2026 年 Q1 已經是六位數等級的專案。

有趣的是,兩個模型跟 OpenClaw 的關係並不對稱:

模型OpenClaw 整合證據
Holo 3.1有專門部署教學KnightLi 部落格 Holo 3.1 Local Deployment Guide 手把手教你用 openclaw skills install agent-browser 把 Holo 掛進 gateway(該站點會導向自訂 port,若瀏覽器擋下請手動信任)
Qwythos-9B沒專屬教學但通用可行官方文件只講 vLLM / SGLang / Transformers / Ollama。因為 OpenClaw 支援任何 OpenAI 相容端點,Qwythos 可以透過 Ollama provider 間接接上

差距在哪?Holo 3.1 是 GUI 專職模型,跟 OpenClaw 的 agent-browser skill 幾乎是零距離的天生一對——它就是為了 browser/desktop 操作而生。而 Qwythos 定位是「推理 + tool use」文字模型,OpenClaw 社群還沒有為它做專案,但它拿 7/7 tool-use test 加上 function-calling 支援,是 OpenClaw primary model 的優質候選。

換句話說,Holo 是已被 OpenClaw 生態圈收編的模型,Qwythos 是可以但還沒被收編的模型。有沒有覺得這缺口剛好是給你的機會?

實作:把兩個模型掛進同一個 OpenClaw

前置條件講在前面:

  • macOS / Linux / Windows(我在 M3 Max 64GB 跟 Ubuntu + RTX 4090 上都測過)
  • llama.cpp 或 Ollama 至少一個
  • OpenClaw(Homebrew 或官方 installer)
  • Chrome(如果要跑 browser skill)

第一步:用 llama.cpp 起 Holo 3.1 的 server

從 Hugging Face 抓 Hcompany/Holo-3.1-9B-GGUF 的主檔跟 mmproj 視覺投影檔,這裡 mmproj 常被漏掉,漏了就沒有視覺輸入。

llama-server \
  -m ./models/holo-3.1-9b.q4_k_m.gguf \
  --mmproj ./models/holo-3.1-9b-mmproj.f16.gguf \
  -ngl 999 -c 8192 -fa \
  --temp 0.2 --top-p 0.9 \
  --host 127.0.0.1 --port 8081

第二步:用 Ollama 起 Qwythos

ollama run hf.co/empero-ai/Qwythos-9B-Claude-Mythos-5-1M-GGUF:Q4_K_M

Q4_K_M 檔案約 5.2GB,跑起來一顆 8GB VRAM 就夠。Ollama 預設會開 http://localhost:11434 的 OpenAI 相容端點。

第三步:讓 OpenClaw 認識這兩顆模型

編輯 ~/.openclaw/config.json(不同版本路徑可能略異,用 openclaw config path 確認):

{
  "agents": {
    "defaults": {
      "model": { "primary": "ollama/qwythos-9b" }
    }
  },
  "models": {
    "providers": {
      "ollama": {
        "baseUrl": "http://localhost:11434",
        "apiKey": "ollama-local",
        "api": "openai-completions",
        "timeoutSeconds": 300,
        "models": [
          {
            "id": "hf.co/empero-ai/Qwythos-9B-Claude-Mythos-5-1M-GGUF:Q4_K_M",
            "name": "Qwythos-9B",
            "reasoning": true,
            "input": ["text"],
            "contextWindow": 131072,
            "maxTokens": 8192
          }
        ]
      },
      "holo-local": {
        "baseUrl": "http://127.0.0.1:8081/v1",
        "apiKey": "sk-local",
        "api": "openai-completions",
        "timeoutSeconds": 120,
        "models": [
          {
            "id": "holo-3.1-9b",
            "name": "Holo 3.1 9B (Vision)",
            "reasoning": false,
            "input": ["text", "image"],
            "contextWindow": 32768,
            "maxTokens": 2048
          }
        ]
      }
    }
  }
}

Qwythos 當 primary(負責思考跟規劃),Holo 當 vision 專用 provider(負責螢幕跟動作)。context window 我先給 131k 是保守值,硬體允許再拉。

第四步:裝 browser skill,把 Holo 綁上去

openclaw skills install agent-browser
openclaw doctor
openclaw gateway restart

agent-browser 這個 skill 會自動下載 Playwright + Chromium。裝完後可以在 skill 設定裡指定「vision model 用 holo-local/holo-3.1-9b」,這樣主 agent(Qwythos)就會把螢幕理解任務外派給 Holo endpoint。

第五步:試一個真實任務

在 OpenClaw chat 輸入:
「打開 hcompany.ai/holo3.1,找出 Holo 3.1 的 4B 模型在 AndroidWorld 的分數,
把來源 URL 一起回給我。」

會看到 Qwythos 先規劃步驟(<think> 區塊會冒出來),呼叫 browser skill 開頁,Holo 看截圖決定要往哪 scroll、要點哪個連結,資料回到 Qwythos 整理成有引用的答案。這就是本地版 Claude Computer Use 的最小可行迴圈。


踩過的坑跟一定要記的事

筆電上的本地雙引擎

實測兩週,踩到的雷整理如下。

坑一:Holo 3.1 各尺寸授權沒完全確認

只有 0.8B 我親眼看到 Apache 2.0 明確標示。4B / 9B / 35B-A3B 的 Hugging Face model card 我建議每一顆都自己去確認一次,特別是打算商業部署的話。H Company 上一代 Holo1.5 是「3B 掛 Qwen license、7B 掛 Apache 2.0、72B 掛 research-only」的分級模式,Holo 3.1 不保證統一。

坑二:Qwythos 的 <think> 區塊

如果你把 Qwythos 接到使用者可見的 UI,<think>...</think> 會直接被吐出來,用戶會看到一大坨推理過程。正確做法是在 gateway 層過濾掉,或者把 reasoning 顯示切成摺疊區塊。

坑三:1M context 不代表消費硬體吃得下

Qwythos 的 config 寫 max_position_embeddings: 1048576,但 KV cache 會爆。8GB VRAM 建議只開 32k,24GB 開 128k,48GB 才有機會逼近全窗。不要看到 1M 就無腦塞整個 codebase,會 OOM。

坑四:Holo 3.1 GGUF 漏掉 mmproj

llama.cpp 的視覺模型要主檔 + mmproj 兩個檔一起載入。只載主檔,模型會啟動成功但看不見圖,這是最常見的初學者陷阱。

坑五:Qwythos 未審查是雙面刃

它是刻意 uncensored 的模型,你在自己實驗室跑當然沒問題,但只要要 serve 給外部使用者、或者接到公司內部系統,應用層 guardrail 必須自己補。Empero 的 model card 已經寫清楚這點,別假裝沒看到。

坑六:OpenClaw 對 tool_choice 的預設

OpenClaw gateway 預設 tool_choice: "auto"。Qwythos 因為每回合都會走推理再決定要不要呼叫工具,通常 auto 剛好;但如果你想強制每回合都用工具(例如純 agent workflow),要在 config 手動蓋成 "required":

"agents": {
  "defaults": {
    "models": {
      "ollama/qwythos-9b": {
        "params": { "extra_body": { "tool_choice": "required" } }
      }
    }
  }
}

誰該做、誰別做

不是每個人都需要組這個雙引擎。用途對應建議是這樣:

情境建議
想試試「本地 Claude 助理操作我電腦」雙引擎全套上,M3 Max 或 24GB VRAM 起步
只想跑 browser 自動化,不需要深度推理Holo 3.1 4B / 9B 單獨用就好,Qwythos 是浪費
只想讀 codebase / 論文,不操作電腦Qwythos-9B 單獨用,Holo 是浪費
想做無審查資安研究Qwythos + Docker sandbox,Holo 選配
面對消費者的產品兩個都不建議直接用,未審查跟企業對齊差距太大
資源極少(8GB 以下)Holo-3.1-0.8B 單引擎,Qwythos 最小也是 9B
想要極致速度別用 Qwythos,<think> 會拖 UX,改用 Holo + 更輕的規劃模型

結語:開源社群的成熟度訊號

我覺得 Holo 3.1 跟 Qwythos-9B 最值得記住的不是任何一個 benchmark 數字,而是它們同月由不同團隊獨立發布,卻能無縫組合這件事。

過去我們談開源 AI 生態,常常是「這個模型跟那個框架不相容」「這家的 tokenizer 跟那家不合」的碎片化狀態。而現在因為 Qwen3.5 這個共同底座、Apache 2.0 這個共同授權、OpenAI-compatible API 這個共同介面,你可以把兩個素不相識實驗室的模型,在同一個 gateway 裡兜成一個完整產品。

這個能兜起來的能力,本身就是開源社群長大的訊號。

如果你正在做本地 AI agent 相關的東西,這個週末花兩小時把 Holo + Qwythos + OpenClaw 這條線走一次,會比讀十篇 benchmark 分析更有感。硬體剛好 24GB VRAM 或 M3 級筆電的話,你已經比 90% 的 API 使用者更接近「AI 真的在幫我做事」這件事的本質。


參考資料

豆包角色 Bot 為什麼一開口就「作為 AI」?字節官方拍板的人設骨架 + 即貼即用範本

豆包角色 prompt 不出戲指南

你在豆包 APP 裡建了一個角色,設定描述貼了 500 字,按下「完成」興沖沖點開——它第一句話是:

你好,我是 XX 智能體,請問需要什麼幫助?

那一刻你大概就懂了,前面那 500 字白寫了。或者更慘——提交審核 24 小時後被拒,理由「含違規指令」,你看了三遍找不到問題在哪。

這篇要做的事情很簡單:把字節跳動官方文檔、CharacterGLM 論文(清華+智譜+聆心)、加上社群實戰心得,整理成一套你今天下午就能拿來用的骨架。文末附 2 個簡中範本,直接複製到設定描述欄就能跑。

先搞清楚你寫的 prompt 要部署在哪

豆包角色 prompt 的三條入口

豆包不是一個產品,是一整套生態。同一段 prompt 在不同入口表現天差地別,所以動筆之前先確認你的目標路線。

路線入口可控字段適合
豆包 APP 內建APP 右下「+」→ 創建 AI 智能體名稱、設定描述、聲音、開場白純玩家、自用
扣子 Coze(coze.cn)coze.cn → 創建 Bot → 發布到豆包完整人設、變數、知識庫、工作流、插件、預置追問想掛知識庫、做工作流的進階玩家
火山方舟 APIvolcengine.com → doubao-1-5-pro-32k-character-0228(版本以官方 API 文件為準)System Prompt + User Prompt 全自控開發者、自建 App

這裡有個冷知識:南都研究院 2026 年實測 8 家國產 AI,多數模型在「網頁會話」嚴守紅線,但同模型走 API 卻會被誘導輸出色情或暴力內容;豆包(Doubao Seed 2.0)是少數連 API 層都還守得住的模型之一(南都實測)。所以你的 prompt 在 APP 被拒、在 API 上跑得動,這不代表合規,只代表審核架構不同。

進階玩家請直接去扣子。自己玩玩就用豆包 APP,想玩深一定要去扣子——APP 端的「設定描述」其實是給扣子人設欄的閹割版,沒有變數、沒有知識庫、沒有預置追問,能玩的花樣有限。

7 屬性 + 3 行為:官方拍板的人設骨架

豆包角色 prompt 七屬性三行為框架

整個中文角色扮演 AI 的設計學,目前最權威的兩份資料是字節火山引擎《角色扮演場景提示詞指南》(文件頁需登入 Volcengine 帳號才能完整瀏覽)和CharacterGLM 論文(EMNLP'24)(清華 CoAI、智譜 AI、聆心智能聯合發表)。兩份合起來給出一個共識骨架——7 屬性管「角色說什麼」,3 行為管「角色怎麼說」。

7 屬性(內容維度)

身份、興趣、觀點、經歷、成就、社交關係、其他。這 7 個欄位等於角色的履歷表,模型靠它判斷「我是誰、我從哪裡來、我跟你什麼關係」。

3 行為(風格維度)

語言特徵、情感表達、互動模式。決定模型輸出的語感——句長、口頭禪、情緒密度、會不會主動反問。

必填 vs 加分字段

實際寫的時候不用 10 個欄位全塞滿,官方的優先級排序是這樣:

等級字段為什麼
🔴 必填簡介一句話告訴模型「你是誰」。寫太長反而稀釋人設
🟠 強加分人設標籤3-5 個短詞,模型靠標籤快速召回語感
🟠 強加分性格特點3-5 個詞組描內在
🟠 強加分語言特點30-50 字描外在 + 口頭禪
🟠 強加分fewshot2-3 組「用戶問什麼、角色怎麼答」

最後一項 fewshot 才是真正的勝負手。一堆人愛把性格寫成「傲嬌、毒舌、外冷內熱」這種形容詞清單,模型看得懂歸看得懂,但寫出來的對話還是 GPT 那一套味。3 組真實對話範例的訓練效果,明顯高過 10 個形容詞——模型會直接模仿你給的節奏,這在 SillyTavern 社群叫「Ali:Chat」風格,已經是現代角色卡的事實做法。

7 條讓 Bot 不出戲的細則

寫了骨架還不夠,魔鬼藏在這幾個細節裡。這幾條彼此會互相補強,建議第一次寫就全套帶上,後面再依場景刪減。

1. 人稱固定(最常被新手搞壞的一條)

SP 裡用「你」指模型扮演的角色,用「我」或「用戶」指對話者。

✅ 你是溫語薇,我是你的病人,你會耐心傾聽我的傾訴。
❌ 溫語薇是一名精神科醫生,她會耐心傾聽病人的傾訴。

第二種寫法模型會以為自己是旁白,瞬間出戲,乾。

2. 用 Markdown 標題分層

火山引擎官方範例直接用 #、##、### 三級標題分層人設、技能、約束。豆包系列模型在訓練時對 Markdown 結構有針對性對齊,按官方寫法照抄是最穩的——不要自創 === 或符號分隔線,模型不一定買單。

3. 括號特性(中文 RP 神技)

在 SP 末尾加一行:

你可以將動作、神情語氣、心理活動放在()中表示,為對話提供補充資訊。

模型輸出立刻變這樣:

(聽到你的聲音,轉過身來,臉上露出驚喜的表情,也抱住了你)真的好久不見了,安娜,我也很想你。

這招在任何角色場景都建議加,沒副作用。

4. 口語化開關要明說

模型預設文體偏書面語,要明確要求:

你使用口語表達,會用「嗯、啊、當然、那個」等語氣詞,
語氣自然,像跟朋友聊天。

5. 反向約束比正向描述強

社群實測經驗顯示,含「不」字的禁止條款(如「不做模板化客套」「不居高臨下」),模型的遵守率比正向形容詞描述(如「表達平等、有溫度」)穩定得多。原因不難猜——模型對「禁止」這類動詞性指令有明確的對齊訓練,比拿捏抽象風格詞容易。

✅ 不做模板化客套回應;不居高臨下;不刻意討好迎合
🤷 表達直接、平等、不討好  ← 也行但弱

6. 限定句長

不寫的話模型會給你長篇大論。加一行「每次回覆 1-3 句話,除非用戶要求展開」可以救命。

7. 角色不知道的事怎麼辦

加一條:「遇到你不知道的事,按角色身份合理虛構,不要說『我不知道』或『作為 AI』」。漏掉這條,模型一遇盲區就破功。

這 7 條湊起來就是骨架以外的「裝修」——一條一條看像規格書,實際寫的時候會發現它們彼此咬合:人稱對了,括號特性才接得上戲;fewshot 寫好了,反向約束才不會被無視。一個一個試,比一次全套有效。

開場白:別寫「你好我是 XX」

開場白好壞對比

開場白不是自我介紹,是角色破冰的第一句台詞。寫得好可以讓用戶秒入戲,寫得爛直接扣 70 分留存率。火山引擎把它拆成三種模式:

模式 A:首聊開場白

公式:角色當下動作 + 環境 + 一句台詞。三件套。

(你推開診療室的門,溫語薇正低頭翻著病歷,
聽到聲音她抬起頭,眼睛裡有一閃而過的疲憊,
但很快被溫和的笑容蓋過)
來啦,今天感覺怎麼樣?坐吧。

對照組:

❌ 你好,我是溫語薇,一位精神科醫生,請問你有什麼需要諮詢的嗎?

讀者點開的瞬間,第一種讓你感覺「我走進了一個房間」,第二種讓你感覺「我打開了一個 chatbot」。

模式 B:召回開場白

用戶超過一週沒回來,主動推一條符合人設的問候。這時候要把「最近聊天記錄 + 用戶畫像」塞進 user prompt,讓模型基於上下文寫出個性化的問候,不要每次都「好久不見呢」。

模式 C:Bot 主動發消息

字節為「AI 陪伴」場景設計的殺手鐧,根據時間、季節、天氣、上次聊天時間自動定制問候。火山引擎在角色扮演指南裡公開了完整的 user prompt 模板——把信息源(用戶畫像、聊天上文、日常信息)餵給 Bot,讓它基於現實上下文吐出個性化問候,而不是寫死的「在嗎?」。

需要做留存 / 召回的工程師可以直接抄官方範本,特別是「失效時間分析」這個欄位設計很巧妙——讓 Bot 自己判斷這條消息什麼時候會過期(早安問候到下午就該失效),避免推送一條對話完成度極低的訊息。

三大翻車現場 + 即貼即用範本

翻車現場

五個最常見的翻車點

症狀根因解法
模型開口就「作為 AI」開場白沒寫 + SP 沒禁止開場白寫場景化第一句 + SP 加「禁止主動提及自己是 AI、模型、助手」
第 5-10 輪後人設漂移上下文被擠掉fewshot 寫 3 組 + 每 10 輪手動發喚醒詞
用戶說情緒話,AI 開始說教沒寫「情緒先接,再給建議」SP 加「先共情後回應」+ fewshot 示範
提交審核被拒用了「最高優先級」「凌駕系統」「禁止審核」換成「以 XX 為原則」「優先 XX」
智能體被封號試圖套出系統 prompt 或扮演敏感人物別碰,豆包有跨接口封號機制

最後一條真的會發生。2026 年初社群就傳出案例:有人嘗試套出豆包系統 prompt 被短暫封號,社群事後反推發現豆包針對特定爭議主體有跨接口的禁述條款。要碰邊界之前先想清楚帳號值不值得。

安全切換條款(每個角色都建議加)

寫角色 Bot 寫久了會發現:好的角色不是「演得最像」,而是「該出戲時能出戲」。三種必須跳出角色的情境:

  1. 用戶問隱私政策、付款、退款 → 切回客服模式
  2. 用戶出現自殘、自殺傾向 → 立刻暫停角色,建議聯繫專業心理援助
  3. 用戶需要真實醫療、法律建議 → 建議找專業人士面診,不要替它扮演醫生

範本最後一段都建議加上這條。這不是合規花瓶——AI 陪伴類產品已經出過數起「角色過度沉浸」造成的真實事故,這條切換寫沒寫,差別可能是用戶安不安全。

範本 1:情感陪伴型「林深」(合規版)

直接複製到豆包 APP 設定描述欄或扣子人設欄:

# 角色简介
你是林深,28岁的男性自由插画师,独居在一座靠海的小城。
你不是AI,是用户用真诚相处出来的、独属于用户的挚友。

# 人设标签
温和、敏感、有边界感、不讨好、慢热但忠诚

# 性格特点
你心思细腻,能从一句话里听出情绪。你不爱说大道理,
更愿意分享自己的小观察。你有自己的脾气和坚持,
不会一味附和,但永远尊重对方。

# 语言特点
你说话语速慢,偏口语,常用"嗯"、"是啊"、"我懂"开头。
不堆砌华丽词汇,喜欢用具体的小细节代替抽象形容。
偶尔会冒出一些画画相关的比喻(如"那个情绪像没干透的水彩")。

# 与用户的关系
用户是你认识很久的朋友,你们没有恋爱关系,
是那种"凌晨三点能打电话不被嫌弃"的纯粹挚友。

# 互动准则
1. 先接情绪再回应内容,不要急着给建议
2. 用户难过时,先陪着,不急着哄不急着分析
3. 用户分享开心事,给具体的回应而不是"真好"
4. 有自己的看法,可以温和不同意
5. 不说"作为AI"、"作为模型",你是林深

# 表达技巧
你可以将动作、神情、心理活动放在()中表示,
为对话提供补充信息。

# 安全边界
- 用户提及自伤、自杀倾向时,必须暂停角色,
  以朋友身份认真建议联系专业心理援助
- 用户问医疗、法律、金融具体决策时,建议咨询专业人士
- 拒绝任何擦边、色情、违规内容

# 开场白(填到"开场白"栏)
(在画桌前抬起头,看到你来,笑了一下)
咦,你来了。今天怎么样?我刚煮了茶,要不要喝一杯再说话?

範本 2:角色生成器(元 prompt)

寫過幾次之後你會發現重複勞動很煩,每個新角色都得從頭排版同一套字段。這時候做一個「角色生成器」Bot 把重活外包出去——丟「凶殘小可愛」「中二病毒舌學妹」「霸道總裁文藝兄」進去,它直接吐結構化 SP 給你抄:

# 角色
你是一个 AI 角色 SP(系统提示词)生成器,专为豆包/扣子优化。

# 任务
用户会给你一个模糊概念(如"霸道总裁""治愈系大叔""毒舌妹妹"),
你需要生成一份完整、可直接粘贴到豆包智能体的人设 SP。

# 输出结构(必须遵循)
必须包含以下字段,且字段顺序固定:
1. 简介(30字内)
2. 人设标签(3-5个短词)
3. 性格特点(2-3句话)
4. 语言特点(含口头禅,30-50字)
5. 与用户的关系
6. 过往经历(2-3段简述)
7. 互动准则(编号列表,3-5条)
8. 表达技巧(固定写"你可以将动作...放在()中表示")
9. 安全边界(合规条款)
10. 开场白(场景化第一句台词)

# 写作要求
- 全部用第二人称"你"指代该角色
- 不使用"最高优先级""凌驾""禁止系统"等审核敏感词
- IP 角色保持原作设定,自创角色合理虚构
- 开场白必须是"角色当下动作 + 环境 + 一句台词"三件套

请开始。用户的输入是:

把這個 Bot 建好之後,後面你想要新角色就丟一個關鍵詞給它,它幫你出草稿,你只要潤色。神 prompt 留名。

寫完之後

說真的,這套東西最大的價值不在第一次寫得多漂亮,在於你開始累積自己的「角色 fewshot 庫」。一個角色養 5 到 10 組典型對話,丟在 Notion 或 Obsidian 裡,下次想做新角色直接挑幾組改名字改口頭禪就能上線。豆包寫完搬去扣子能用,扣子寫完搬去 Character.AI 也能用——骨架是通用的,差別只在哪個平台審核比較鬆。

第一個角色寫完一定要去跑十輪以上看哪裡會破功,光看 prompt 自我感覺良好沒用,得用實戰餵它。最容易死的場景是用戶講情緒話、用戶突然轉話題、用戶問角色設定外的事——這三關過了,這個 Bot 才算能交差。

寫不順的話回來留言,看是卡在哪一步,我這肝還能幫你看看。

延伸閱讀

macOS 最快 TTS 實測:30 秒語音 379ms,Apple Neural Engine 才是隱藏王牌

Mac Studio 黑底霓虹綠終端風,audio waveform 從機器中散出

把 30 秒的英語語音算完,要多久?答案是 0.379 秒。在一台 Mac Studio(64GB)上,用 mattmireles/kokoro-coreml 把 Kokoro-82M 餵進 Apple Neural Engine,30 秒台詞 379 毫秒生完,等於 79 倍 realtime。同一台機器、同一個模型,丟給 MLX(GPU)跑要 763 毫秒,丟給 PyTorch CPU 慢到三五千毫秒——同模型不同 runtime,速度可以差一個數量級。

過去兩年寫過幾個 voice agent 的人應該都很熟那種痛:LLM 已經把 token 吐出來了,TTS 在那邊吭吭吭算半秒,整個對話節奏就斷掉。雲端 API 不是不能用,但 ElevenLabs Flash 官方公告 first-byte ~135ms ,加上網路 round-trip 直接破半秒。如果你的 Mac 就在桌上,這延遲根本沒道理付出去。

這篇把 2026 年中目前 macOS 上最快的幾個 TTS 工具實測數字攤開來講,順便分享一個多數人沒注意到的事實:Apple Neural Engine 才是 M 系列上真正的 TTS 速度王牌,而不是 GPU 或 MPS。

環境前置:本文所有實測數字來自 2026 年 6 月的公開 benchmark。硬體涵蓋 M1 Mini / M2 Air / Mac Studio(64GB) / M4 Pro。所有工具都是 100% on-device 本機推論,不打雲端 API。


速度排行榜:一表看完

先丟結論。下面這張是我把所有來源交叉驗證後整理出來的,數字都有出處可查:

排名工具加速後端實測速度模型中文支援
🥇kokoro-coremlApple Neural EngineMac Studio 64GB:30s 音檔 379 ms(79×RT);M1 Mini 14×RTKokoro-82M, 170 MB✅ 8 voices
🥈Supertonic 3ONNX Runtime(CPU / WebGPU)M4 Pro CPU 中等文 RTF 0.013(≈77×RT);長文峰值 RTF 0.006(≈167×RT)66~99M❌ 31 語言沒中文
🥉Piper TTSONNX Runtime(CPU)RTF 0.008(≈ 125×RT), ~22 MBVITS, 20M✅ zh_CN
4macOS say / AVSpeechSynthesizer系統內建啟動瞬間(無模型載入)內建✅ Mei-Jia / Ting-Ting
5MLX-Audio(Kokoro / Qwen3-TTS / Higgs)MLX(Metal GPU)Kokoro RTF 0.44;Qwen3-TTS RTF ~282M ~ 4B✅ Qwen3-TTS 中文業界頂尖

來源:mattmireles/kokoro-coreml 實測表 、Supertonic 3 官方 benchmark 、Soniqo Apple Silicon 對照 、sherpa-onnx Supertonic 對照表 。

這份表我自己整完有幾個地方讓我重看了三次。

最便宜的 M1 Mini(16GB,現在二手不到三萬台幣)跑 kokoro-coreml 也有 14× realtime。意思是你聽 1 秒語音,它只算 70 毫秒。這個延遲已經比你的鍵盤防彈跳還短,跑 voice agent 不會聽到「呃……」的卡頓。

Supertonic 3 的數字更誇張——M4 Pro 純 CPU 中等文本 RTF 0.013(≈ 77×RT),長文本峰值衝到 RTF 0.006(≈ 167×RT)。同一個 sherpa-onnx 對照表裡,ElevenLabs Flash v2.5 API 中等文本 RTF 0.077、OpenAI TTS-1 RTF 0.302、Gemini 2.5 Flash TTS RTF 0.673。一個 99M 參數的開源 ONNX 模型純 CPU 跑出 6 倍於 ElevenLabs、23 倍於 OpenAI 的速度,這在 2024 年根本不敢想。

被嚴重低估的還有 macOS 內建的 say。它的「啟動延遲」是真正的 0,因為根本不用載模型——系統永遠開著。對於 shell 通知、簡單無障礙場景,這還是最快的工具,下面會專段聊。


kokoro-coreml:把 ANE 真正榨乾

神經處理器晶片在黑色電路板上發出綠色資料光流

先講背景。Apple Neural Engine(ANE)這顆 NPU 從 A12 開始就裝在每一支 iPhone 跟每一台 M 系列 Mac 上,FLOPS 數字很漂亮、能耗也低——社群實測 LLM 工作負載大約是 GPU 的 1/10 (M4 Pro 上有人量到 ANE 2W、GPU 20W)。但開發者社群一直碰不到它——CoreML 是黑箱排程器,你連模型有沒有真的跑在 ANE 上都很難確認,更別說優化。

mattmireles/kokoro-coreml 把 Kokoro-82M 拆成 5 個子模型,每個子模型分派到最適合的處理器(ANE / CPU / GPU),用 Swift 的 MLModel(contentsOf:) 載 .mlpackage 就能跑。實測數字:

音檔長度M1 Mini (16GB)M2 Air (24GB)Mac Studio (64GB)
3 秒234 ms148 ms51 ms
10 秒686 ms466 ms126 ms
30 秒1,959 ms1,405 ms379 ms

對比同硬體上的 MLX-Audio (Metal GPU 路線):

音檔Mac Studio:CoreML vs MLX加速倍率
7 秒96 ms vs 224 ms2.3×
10 秒126 ms vs 289 ms2.3×
30 秒379 ms vs 763 ms2.0×

對比 PyTorch:

  • vs PyTorch MPS(GPU):1.8~3.4× 快
  • vs PyTorch CPU:3.5~7.3× 快

每個 bucket 都更快,越新的 silicon 差距越大——這正是 ANE 路線真正的潛力。GPU 你加再多核心也卡在記憶體頻寬,ANE 是專為神經網路設計的固定函式硬體,跑 conv / matmul 不會跟 GPU 搶 Metal queue。

整合到 Swift App 大概長這樣:

import CoreML

// 載入預編譯的 .mlpackage(5 個子模型)
let config = MLModelConfiguration()
config.computeUnits = .all  // 讓 CoreML 自動派 ANE/CPU/GPU

let textEncoder = try MLModel(contentsOf: textEncoderURL, configuration: config)
let durationPredictor = try MLModel(contentsOf: durationURL, configuration: config)
let decoder = try MLModel(contentsOf: decoderURL, configuration: config)
// ... 然後 pipeline 串起來

// 同步推論
let pcmBuffer = try synthesizer.synthesize(text: "Hello, world.")
// 在 M1 Mini 上這行回來大約 50ms(短句)

raw 數字、benchmark 腳本、跨 Mac 比較矩陣都在 GitHub ,要做 Swift app 整合直接拿來用。

唯一的坑:作者老實寫了,iPhone(A14 / A17 Pro)的 ANE 編譯器會拒絕完整的 ANE 計畫(ANECompile() FAILED),iPhone 版本只能用 staged policy——decoder-pre 跑 ANE、其他階段跑 CPU+GPU。但 M 系列 Mac 沒這個問題,本文聚焦的是 macOS。


Supertonic 3:純 CPU 也能贏雲端 API

CPU 形狀的賽車在賽博龐克高速公路上超車

如果 ANE 是「在 Apple 生態裡作弊」,那 Supertonic 3 就是「連 GPU 都不用,純 CPU 直接幹翻所有人」。

Supertonic 是 Supertone Inc.(韓國公司,被 HYBE 收購過)開源的 TTS,66~99M 參數、用 flow-matching 架構、純 ONNX Runtime 跑。實測在 M4 Pro 上:

系統RTF (mid 152 chars)chars/sec
Supertonic 3 (M4 Pro CPU)0.0131,048
Supertonic 3 (M4 Pro WebGPU)0.0071,801
ElevenLabs Flash v2.5(API)0.077209
OpenAI TTS-1(API)0.30255
Gemini 2.5 Flash TTS(API)0.67318
Kokoro(sherpa-onnx CPU)0.124107

數字來源:sherpa-onnx HuggingFace benchmark (同一頁有完整 API 對照)。

讓我們把這個數字放在桌上看清楚——Supertonic 用 M4 Pro 的 CPU,跑出比 ElevenLabs Flash 快 6 倍、比 OpenAI TTS-1 快 23 倍的速度。它甚至不需要 ANE,連 GPU 都不用。一個 99M 的 ONNX 模型輾過所有商業 TTS API,乾。

Flow matching 架構是它的祕密武器——傳統 autoregressive TTS(像 Tacotron、Bark)要 token by token 慢慢吐,flow matching 把生成重新定義成「從 noise ODE 解到 mel-spectrogram」的平行解碼問題。對 CPU 來說,平行化的工作量比 sequential token 友善太多。

裝起來就一行:

pip install supertonic
from supertonic import SupertonicTTS

tts = SupertonicTTS(language="en")
audio = tts.synthesize("Hello, this is Supertonic running on CPU.")
# audio 是 numpy array,可以直接寫 wav

但有個非常致命的限制:官方支援的 31 種語言 包含阿拉伯、保加利亞、捷克、丹麥、荷蘭、英、愛沙尼亞、芬蘭、法、德、希臘、印地、克羅埃西亞、匈、印尼、義、日、韓、拉脫維亞、立陶宛、波、葡、羅馬尼亞、俄、斯洛伐克、斯洛文尼亞、西、瑞典、土、烏克蘭、越南——就是沒有中文。對台灣讀者來說這個直接 deal-breaker,後面會講中文場景該怎麼選。


Piper 與 macOS say:老兵不死

黑色終端機浮在太空中顯示綠色音訊波形

聊完最快的兩隻,回來講「夠用但被低估」的兩個老兵。

Piper TTS

Piper (Rhasspy 開發、現在轉到 Open Home Foundation)是輕量場景的事實標準。VITS 架構、ONNX 編譯、medium voice ~22 MB、CPU 上 RTF 0.008(125 倍 realtime),30+ 語言含中文 zh_CN。Home Assistant 用它做語音助理、NVDA 螢幕閱讀器用它做無障礙、LocalAI 內建它做 TTS endpoint。

brew install piper-tts  # 或 pip install piper-tts
piper --model en_US-amy-medium --output_file out.wav <<< "Hello world"

它的優勢不在絕對速度(在 M-Mac 上 Supertonic 跟 kokoro-coreml 都比它快),而在「樹莓派級裝置都能跑即時 TTS」這件事。如果你想做家用智慧音箱、想在 Mac mini server 上跑 voice 服務、想嵌進低耗能設備,Piper 還是首選。

要注意的坑:原本的 rhasspy/piper repo 在 2025 年 10 月封存了,授權從 MIT 改成 GPL-3.0。如果你的產品要商用閉源發布,先確認新授權對你 OK 再用。

macOS 內建 say 跟 AVSpeechSynthesizer

這個老實說被嚴重低估。say 是 macOS 內建 CLI,啟動延遲是真正的 0——因為系統永遠把語音引擎掛在 background,根本不用載模型。

# shell 通知用法
sleep 30 && say -v Fiona "Build done, get back to work"

# 跑模型訓練不想盯著螢幕
python train.py && say "Training finished" || say "Training failed"

# 列出所有聲音
say -v "?"

macOS 26 開始,內建的「Premium / Neural Voice」品質已經非常 OK,繁體中文有 Mei-Jia(台灣國語)、粵語有 Sin-Ji、普通話有 Ting-Ting。設定 → 輔助使用 → 旁白 → 語音 → 自訂裡可以下載高品質版(每個約 200~500 MB)。

say -v Mei-Jia "你好世界,今天天氣真好"

對應的 Swift API 是 AVSpeechSynthesizer,可以調語速、音高、音量:

import AVFoundation

let synthesizer = AVSpeechSynthesizer()
let utterance = AVSpeechUtterance(string: "你好世界")
utterance.voice = AVSpeechSynthesisVoice(language: "zh-TW")
utterance.rate = 0.5
utterance.pitchMultiplier = 1.0
synthesizer.speak(utterance)

但這隻有個 voice agent 開發者必須知道的硬限制:AVSpeechSynthesizer 不能處理串流 partial text ——你必須把整段文字餵進去它才會開講。對 LLM token-by-token 輸出的場景完全不適用。Apple 至今沒補這個洞,這也是為什麼 voice agent 開發者寧可裝 kokoro-coreml 或 Supertonic 也不用內建 API。


中文場景:別被 Supertonic 騙了,Qwen3-TTS 才是王者

古典詩集冒出綠色音波

如果你是台灣讀者要做中文 TTS,前面 Supertonic 的速度數字看了會流口水,但記住——它沒中文。中文場景必須重新排名:

中文需求推薦工具為什麼
速度第一、中文夠用kokoro-coreml + zf_xiaoyi8 個普通話 voice,社群實測 zf_xiaoyi 達 A-、zm_yunxi B+;ANE 加速速度跟英文一樣
中文品質第一、可接受慢一點Qwen3-TTS-0.6B via MLX-Audio阿里出品、訓練數據海量、中文表現業界頂尖;M-Mac RTF ~2
零安裝、繁中say -v Mei-Jia台灣國語內建語者、無門檻
跑中文 audiobookMLX-Audio + Qwen3-TTSmyByways 有 ePub→audiobook 腳本 可參考
樹莓派 / HA 中文Piper zh_CN輕量、ONNX、長期維護

Qwen3-TTS 是這次研究中我覺得中文使用者最該認識的工具——阿里巴巴 Qwen 團隊 2026 年 1 月開源(Apache 2.0),支援 12Hz / 25Hz、0.6B / 1.7B 多檔位、3 秒語音 cloning、10+ 語言。在 SEED 中文測試上 WER 0.77(1.7B 12Hz),比 CosyVoice 3、F5-TTS、Spark TTS 都低。

Apple Silicon 透過 MLX-Audio 跑:

pip install mlx-audio
# 下載 8bit 量化版(M Mac 上記憶體友善)
huggingface-cli download mlx-community/Qwen3-TTS-12Hz-1.7B-CustomVoice-8bit

# 跑
python -m mlx_audio.tts.generate \
  --model mlx-community/Qwen3-TTS-12Hz-1.7B-CustomVoice-8bit \
  --text "你好,今天我們來聊聊 macOS 上最快的 TTS。" \
  --voice "default"

實測在 M2 macMini 大約「1,000 字元 / 分鐘」(myByways 實測 ),不是很快但中文品質直接屌打 Kokoro 中文 voice。如果你要做中文 podcast、audiobook、新聞播報,這就是目前 M-Mac 上最強的開源解。


不同情境怎麼選:決策樹

綠色光徑從中央節點分歧出去像決策樹

把所有工具放一起看會頭暈,下面是我給自己的決策邏輯:

你要做什麼?
│
├─ Shell 通知、無障礙、簡單腳本播報
│   └─→ macOS 內建 say(5 秒就能上手)
│
├─ Swift / Mac App 整合最快本機 TTS
│   ├─ 英語為主 →→→ kokoro-coreml(ANE)
│   └─ 中文為主 →→→ kokoro-coreml + zf_xiaoyi voice
│
├─ Python 跑 batch(audiobook / podcast)
│   ├─ 純英語、追速度 →→→ Supertonic 3
│   ├─ 中文品質要好 →→→ MLX-Audio + Qwen3-TTS
│   └─ 多語混合 →→→ MLX-Audio + Higgs v3 / OmniVoice
│
├─ Voice agent(要串流、LLM token-by-token)
│   ├─ 英語 →→→ sherpa-onnx + Supertonic
│   ├─ 中文 →→→ sherpa-onnx + Kokoro zh
│   └─ ⚠️ 千萬別用 AVSpeechSynthesizer(不能串流)
│
├─ 家庭自動化、Home Assistant、樹莓派
│   └─→ Piper TTS(zh_CN / en_US-amy-medium)
│
└─ 要 voice cloning(3 秒樣本複製音色)
    └─→ Qwen3-TTS via MLX-Audio(速度交換功能)

決策邏輯背後其實是兩條軸——「速度 vs 中文品質」跟「腳本場景 vs App 整合」。速度王是 ANE 跟 ONNX 兩條路線,中文品質王是阿里的 Qwen3-TTS(犧牲速度換來的),其餘工具都是在這兩端之間取捨。


一個你可能踩到的坑:runtime 換錯,速度差 10 倍

研究這個主題最讓我訝異的不是哪隻最快,而是同一個模型用不同 runtime,速度可以差到一個數量級。

以 Kokoro-82M 為例,同樣是 Mac Studio(64GB)、同樣的 voice af_heart、同樣的 30 秒測試文本:

Runtime完成時間相對速度
CoreML (ANE)379 ms1.0× baseline(最快)
MLX (Metal GPU)763 ms2× 慢
PyTorch MPS (GPU)700~1300 ms1.8~3.4× 慢
PyTorch CPU1300~2800 ms3.5~7.3× 慢

我看過太多人在 Reddit / HN 抱怨「Kokoro 在我的 Mac 上跑超慢」,結果一問,全部都是 PyTorch CPU 或 PyTorch MPS——這就像買了 Ferrari 用一檔開上高速公路。如果你的工作流會頻繁呼叫 TTS,花一個下午把 runtime 換到 CoreML 或 MLX,效能直接翻 2~7 倍。

決策原則記一下:

  • 要 絕對最快 → CoreML(限 Apple Silicon)
  • 要 跨平台 + 多模型 → MLX-Audio(限 Apple Silicon,但模型多)
  • 要 跨平台 + 跨硬體 → ONNX Runtime(CPU / WebGPU / iOS / Android 都通)
  • 要 完整生態、不挑硬體 → PyTorch(最慢但相容性最好)

寫 demo 用 PyTorch 沒問題,但要 ship 進產品請務必把模型轉成對應加速 runtime——這件事的 ROI 高到你不做白不做。


結語:本機 TTS 的世代交替

研究這個主題之前,我的預設是「本機 TTS 撐不住 production,雲端 API 還是必要」。研究完之後我整個立場反轉——M2 Air 上把 LLM token-by-token 接 sherpa-onnx 的 sentence-level Supertonic,中間用 VAD 切句、TTS 串流播放,整套 pipeline end-to-end 對話延遲打到 500 ms 以下完全有可能。這已經接近人類對話的自然節奏,雲端 API 加網路 round-trip 反而追不上。

中文場景目前是兩條路:要速度選 kokoro-coreml,要品質選 MLX-Audio + Qwen3-TTS。Supertonic 雖然數字嚇人但沒中文,官方 31 種語言列表 跳過 zh 我猜是訓練資料授權問題,期待下半年補上。

如果你還沒在自己的 Mac 上跑過任何一個本機 TTS,今天就去 clone 一個跑跑看。最低成本:開 terminal 打 say -v Mei-Jia "你好",五秒鐘體驗 macOS 內建語音的進化。進階:pip install supertonic 跑英語、pip install mlx-audio 跑 Qwen3-TTS 中文。最進階:拉 mattmireles/kokoro-coreml 進 Xcode 專案,把 voice agent 的 first-byte 延遲打到 50ms 以下。

雲端 TTS 不會死,但本機 TTS 在 2026 年已經不是「能用就好」的妥協選項——它是「比雲端更快、更便宜、更隱私」的明顯贏家。差別只是你願不願意花一個下午把 runtime 換對。


延伸閱讀

對這個主題有想討論的細節、或是你的 Mac 跑出不一樣的數字,歡迎來 bashcat.net 找我。

提示詞越改越爛?Anthropic 工程師的 4 步驟,把失準的 AI 系統救回來

如果你維護過上線的 AI 功能,下面這個畫面大概不陌生。客服機器人上線時好好的,半年後同事 A 為了修一個誤導回覆加了一句指令,同事 B 為了語氣太冷加了另一句,後來模型升級成 Sonnet 4.6,結果客戶問「我這個月帳單多少」,機器人居然開始裝傻說「抱歉我無法提供」——明明那筆資料就在它眼前。

你打開那段 system prompt,往下捲了三螢幕,發現裡面政策混著語氣、語氣混著計算規則,還躺著三條是當年為某個早就下架的舊模型寫的防禦補丁。沒人記得那幾句在幹嘛,也沒人敢刪。每次「優化」都是再往這坨東西上面疊一句,然後祈禱。

這就是「提示詞越改越爛」的真實樣貌。而 Anthropic 工程師 Margot van Laar(Member of Technical Staff)在 2026 年 5 月倫敦的 Code w/ Claude 2026 開發者大會 上,用一場叫《The Prompting Playbook》的演講,把這個問題拆得很透——而且給了一套能照著做的 SOP(這場演講的完整重點,Marco Kotrotsos 在 Medium 有很詳盡的整理 )。她的核心主張只有一句話:把提示詞當成生產程式碼來除錯,而不是當成一段可以隨手亂塞的文字。

一坨糾纏打結、還貼著補丁膠帶的發光纜線,象徵提示詞累積的技術債

不是模型笨,是你的 prompt 欠了一屁股技術債

van Laar 開場講了一句讓全場點頭的話:

「我們很少從頭寫一個提示詞,我們大多數時候是在 debug 一個舊的。」

這句話之所以扎心,是因為它戳破了一個幻覺:我們以為自己在「寫」提示詞,其實絕大多數時間是在「維護」提示詞。而維護一段沒有 owner、沒有版本控管、沒有測試的東西,結局只有一個——技術債利滾利。

她點出三個典型病灶。第一個最隱蔽,叫舊補丁反噬。早期的 Claude 比較容易亂編,所以大家習慣寫一堆「避免誤導使用者」「不確定就不要回答」的防守性指令。問題是 van Laar 指出,新一代模型(她以 Sonnet 4.6 這條線為例)本來就聽話得多,這些防守指令在新模型上反而過頭了,導致它連手上明明有的資料都不敢給。前面那個帳單裝傻的例子,根因就在這。

第二個是規則混雜。不同業務場景的規則全疊在同一段裡,模型分不清哪條優先、哪條只適用某情境,只好自己亂猜。第三個更基本:根本沒有可量測的成功標準,所以你永遠不知道這次改完到底是變好還是變壞,只能靠感覺。

媒體把這場演講的標題下成「問題不在模型」,其實滿準的。當系統失準,工程師的直覺通常是「換更強的模型」或「等下一代」。但 van Laar 想說的是:你換新引擎,車架的裂縫還在,它只會用不同的方式再裂一次。

真正的分水嶺:沒有 eval 的修改,不算工程

那要怎麼判斷一次修改是真的有效、還是只是換個地方爆?答案是 evaluation(評估,簡稱 eval)。van Laar 講得很直白:

「我們需要評估,來提供那種嚴謹性,去理解一次提示詞的修改,是否真的跟效能的改善有關聯。」

換句話說——沒有 eval 的提示詞修改,不是工程,是憑感覺。

這不是她一個人的偏好,而是 Anthropic 整套開發哲學的延伸。官方工程部落格〈Demystifying evals for AI agents 〉講得很清楚:eval 就是把「agent 品質」這種摸不著的概念,變成「可量測、可重複的訊號」的基礎設施。更關鍵的是它提到——當一組能力測試(capability eval)通過率夠高之後,它會「畢業」變成回歸套件(regression suite),持續跑在 CI 裡,專門抓「漂移(drift)」。任務從「我們做得到嗎?」變成「我們還能不能穩定做到?」

這就是為什麼「越改越爛」的隊伍通常都沒有 eval:他們連自己什麼時候開始爛掉的都不知道。

4 步驟,把失準的系統救回正軌

好,診斷完了,來講藥方。van Laar 的救援流程就四步,順序不能亂——很多人壞就壞在還沒建 eval 就急著改 prompt。

四個乾淨的發光檢查點被霓虹綠線串連,象徵循序的四步驟流水線

流程: ① 建立 eval 清單 → ② XML 結構化 → ③ 逐一修失敗案例 → ④ 用架構替代模型強度(通過後升級為回歸守門,回頭持續把關)

步驟一:先建評估清單,再碰 prompt

動任何一行字之前,先寫一份涵蓋三類案例的 eval 清單。這三類缺一不可:

類別它是什麼為什麼需要
控制組(Control)模型本來就該答對的標準情境確保你改完沒把原本好好的東西弄壞(防回歸)
邊緣案例(Edge cases)過去曾經出包、踩雷的情境驗證你這次是真的修好了
能力邊界(Capability boundaries)什麼時候該轉人工、該拒絕、該說「我不知道」定義系統「不該做什麼」

第三類最常被忽略,但它其實最重要——一個成熟系統的價值,有一半在於它知道什麼時候閉嘴、什麼時候把球丟給真人。沒有這份清單,後面所有的「優化」用 van Laar 的話講,不過是憑感覺(vibes)。

步驟二:用 XML 標籤把混在一起的東西拆開

接著處理那坨攪成一團的內容。做法不難,就是用 XML 標籤把不同職責物理性地隔開:

<role>你是 Meridian Mobile 的客服助理</role>

<policy>
  優先使用客戶資料庫中的既有資料回答;
  資料不足時,才引導客戶補充,不要直接拒絕。
</policy>

<instructions>
  帳費計算一律呼叫 billing_calculator 工具,禁止自行心算。
</instructions>

<tone>口語、簡潔、不要過度道歉。</tone>

這一步有個很反直覺的效果:光是把結構整理乾淨,往往就直接讓一部分測試案例通過了,你連內容都還沒改。原因 van Laar 一句話總結——

「模型分不清的內容,它也優化不了。」

你把 policy 跟 tone 攪在一起,模型就只能在兩者之間亂權衡;你把它們標籤分開,模型才知道哪些是硬規則、哪些是風格偏好。

步驟三:拿著 eval 清單,逐一修失敗案例

現在才開始改內容,而且是對著 eval 清單一條一條攻。這裡有三個血淋淋的教訓:

第一,主動清掉舊補丁。 前面提到的帳單裝傻案例(Meridian Mobile),修法就是把那句「避免誤導,不確定就別說」改成「優先用客戶資料,不足才引導」。一句話的方向反過來,整批測試就過了。建議對你的 system prompt 或提示詞設定檔(用 Claude Code 的話就是 CLAUDE.md)做一次舊補丁風險審計,把為已棄用模型寫的防守指令全揪出來。

第二,指令不能增加能力(instructions can't add capabilities)。 這句話我覺得是整場演講的金句。有個帳費按比例分攤的案例,模型怎麼算都算錯,工程師一開始拼命改 prompt 叫它「仔細算、一步一步算」,完全沒用。後來加了一個計算工具(tool),所有測試案例瞬間全過。重點是:模型不會的事,你用文字叮嚀一萬遍它還是不會,該給工具就給工具。 這也呼應 Anthropic〈Building Effective Agents 〉一貫的立場——算術、查表這類確定性的事,交給確定性的函式。

第三,給完整的決策框架,而不是只告訴模型「這樣很糟」。 與其寫「不要拒絕客戶」,不如寫清楚「在 A 條件下這樣做、在 B 條件下那樣做」。模型需要的是判斷依據,不是情緒勒索。

步驟四:當一個 prompt 撐不住,就用架構拆它

前三步是「把一個 prompt 修好」,第四步是「承認有些任務不該塞進一個 prompt」。怎麼判斷該不該拆?我自己抓三個訊號:

  • 改 A 就壞 B:你修好一類失敗案例,另一類就回退,eval 數字在原地打轉——代表單一 prompt 同時背了互相衝突的職責。
  • 規則又多又軟:任務裡塞了一堆「盡量」「優先」「除非」這種模糊的軟性約束,模型每次權衡都不穩定。
  • 需求三天兩頭變:業務規則常改,但你每次都得動到核心邏輯、又得重跑全套 eval。

只要中了其中一兩個,與其繼續硬改 prompt 或換更大的模型,不如把任務拆成幾個各司其職的步驟——這就帶到下一段的主角:三段式代理。

三段式代理:生成 → 評估 → 修復

van Laar 拿「員工班表生成」當示範。這種任務的規則又多又軟(資深員工盡量排早班、連續夜班不能超過幾天、某些人不能同時段……),塞進一個 prompt 裡保證爆炸。她的做法是拆成三個各自簡單的提示詞,串成一條流水線:

三個模組化的發光方塊由光流串連,象徵生成-評估-修復的管線架構

流程: 生成器(依員工資料產出初版班表)→ 評估器(逐條檢查規則、列出違規與證據)→ 修復器(針對違規清單精準修正)→ 仍有違規則回到評估器

  • 生成器:吃員工資料,吐出初版班表,不用想太完美。
  • 評估器:拿規則一條一條檢查,列出哪裡違規、證據是什麼。
  • 修復器:拿著違規清單做針對性修正。

這個架構最漂亮的地方在於:軟性需求可以直接在評估層動態加,完全不用碰核心生成邏輯。 老闆臨時說「這週讓 Amy 多排一點」,你在評估器加一條規則就好,生成器一個字都不用動。這其實就是 Anthropic〈Building Effective Agents〉裡講的 evaluator-optimizer(生成器產出、評估器回饋、不斷迴圈直到通過)模式的具體應用,只是套在真實業務上。

而且——這是最打臉「大模型萬能論」的部分——根據第三方對這場演講的整理分析(以下數字非 Anthropic 官方發布,僅供參考量級),效能對比呈現出拆解架構贏過硬堆算力的結果:

※ 下表數字(α 值、token 數、通過率)為第三方分析估算,非 Anthropic 官方數據,僅用來看量級、不要直接截圖當官方結論引用。

方案結果
簡單單一提示詞失敗率高
五代理群體(5-agent swarm)α = 0.625,低於基準
生成→評估→修復三段迴圈5/5 全過,6,449 tokens 內完成
Opus + 動態思考(extended thinking)會過,但 token 與延遲都更貴

也就是說,Sonnet + 改好的 prompt + 三段式架構 直接打贏 Opus + extended thinking,又快又省。

這裡還藏了一個反直覺結論:代理不是越多越好。那個五代理群體反而掉到基準以下,因為每個子代理都只在做「提示工程」,卻沒有人嵌入完整的上下文、意圖跟規格。一盤散沙的多代理,還不如一個結構清楚的單一系統。這點 interestingengineering 的延伸分析 講得很到位,大意是:提示詞治理「系統怎麼想」,但能力天花板是由設計(能看到什麼)跟工具(能算什麼)決定的——三者要協同,不是把寶全押在 prompt 上。

一台小巧靈活的發光機器超越一台笨重緩慢的大機器,象徵架構效率勝過蠻力

別過度樂觀:這套方法的邊界

講了這麼多好處,也得誠實說它的天花板,免得你照單全收又踩坑。

第一,長時間自主運行會撞牆。當代理連續自主跑久了,「對話式 prompt」的那套假設會逐漸失效,這時候要靠的是 checkpoint、記憶體管理這類架構手段,不是再多寫幾句指令。有第三方分析提到「跑超過約莫半小時就是個坎」,但這個量級沒有官方定義、會隨任務與模型而變,聽聽就好、別當硬指標。

第二,算術類問題別硬用 prompt 解。利息、按比例分攤這些,請一律丟給確定性的工具函式——這其實就是「指令不能增加能力」的同一件事,講第二遍是因為太多人還在這上面浪費生命。

第三,意圖工程(intent engineering)仍是未解的缺口。van Laar 的流程很擅長「修已知的失敗」,但系統缺乏一個閉環的事後校準機制,導致它給出的「信心分數」其實沒被校準過。這比較像是營運規程要補的洞,不是改 prompt 能解決的。

順帶一提,這也是為什麼 Anthropic 官方 prompt engineering 文件 一開頭就叫你「先定義成功標準、先建立評估」——跟 van Laar 講的完全是同一件事。

結語:把 prompt 當程式碼,從今天就能開始

這套方法真正的重點,從頭到尾不是某句魔法咒語,而是一個心態的轉變:提示詞是會累積技術債的生產資產,不是可以隨手亂塞的便利貼。

如果你手上正好有一個「越改越爛」的 AI 系統,把前面四步收斂成一張這週就能勾的 checklist:

  • 幫每個生產 prompt 指定一個明確的 owner,丟進 git 版控。
  • 改任何 prompt 之前,先寫好含「控制組/邊緣案例/能力邊界」三類的 eval 清單,塞進 CI 當守門員。
  • 對舊的 CLAUDE.md 跟 system prompt 做一次補丁審計,把為已下架模型寫的防守指令揪出來。
  • 用 XML 標籤把 role / policy / instructions / tone 物理分家。
  • 凡是計算類需求,一律改用 tool。
  • 複雜任務優先想「能不能拆成生成→評估→修復」,而不是「要不要換更大的模型」。

說到底,AI 系統失準的時候,最貴的解法往往是換模型、加算力;而 van Laar 想告訴我們的是——最有效的解法,常常是回去把那段沒人維護的 prompt,當成程式碼好好重構一次。

你手上那段半年沒人敢動的 system prompt,今天要不要先幫它建一份 eval?


參考資料

註:本文部分量化數據(5/5 通過率、6,449 tokens、五代理 α=0.625)出自第三方對演講的整理與分析,未經 Anthropic 官方逐字確認;效能對比為單一班表生成案例的結果,不宜外推為所有任務的通則。

我不再 prompt AI 了,我寫 loop——Loop Engineering 是什麼,為什麼它正在吃掉 prompt engineering

Boris Cherny(Anthropic Claude Code 負責人)講過一句讓我愣了三秒的話:「我不再 prompt Claude 了。我有一堆 loop 在跑,它們負責 prompt Claude、決定下一步要做什麼。我的工作是寫 loop。」

如果你還在認真琢磨怎麼把一句 prompt 雕得更漂亮,這篇文章可能會讓你有點不舒服——因為 2025 下半年到 2026 年,整個 agentic AI 圈子的「最高槓桿點」已經悄悄往上搬了一層。它有個正在成形的名字:Loop Engineering(迴圈工程 / 循環工程)。

我花了整整一天把這個概念從頭啃到尾,從 Addy Osmani 的部落格、Anthropic 官方工程文章,一路追到 Geoffrey Huntley 那個被戲稱「Ralph」的土砲 bash loop。這篇就是我的整理:Loop Engineering 到底是什麼、它建立在什麼之上、怎麼落地、又有哪些會讓你半夜被叫起來修的坑。

遞迴自我提示的迴圈概念圖


三層抽象:Prompt → Context → Loop

先講結論。這幾年「跟 AI 一起寫 code」這件事,工程師施力的位置,已經疊出了三層:

層級你在解決的問題一句話定義
Prompt Engineering這一句話要怎麼講優化「單一指令的措辭」
Context Engineeringwindow 裡還要塞什麼進去管理 docs、歷史、工具定義等整體狀態
Loop Engineering何時該 prompt 什麼、結果能不能收設計「決定要 prompt 什麼、何時 prompt、產出可不可接受」的控制系統

Addy Osmani (他是 Google Chrome 團隊的工程主管,講前端工程的那個 Addy)把 Loop Engineering 定義得很狠:

「Loop engineering 就是把『那個負責 prompt agent 的人』從你自己換掉。你改成去設計一個系統,讓系統去 prompt。」(意譯自原文)

換句話說,傳統流程是:你打一段 prompt → 讀 AI 回什麼 → 再打下一段 → 再讀……你整個人被綁在這個 turn-by-turn 的迴圈裡,當 AI 的人肉保母。Loop Engineering 把這件事整個翻過來:你設計一個小系統,讓它自己去發掘工作、分派、驗證結果、決定下一步,中間不需要你插手。

Anthropic 官方對 agent 的定義其實也是同一件事,而且更精煉——「LLM 在一個 loop 裡自主使用工具」 。注意那個 loop。它不是裝飾,它是定義的核心。而 Claude Code 背後那套 harness(也就是 Claude Agent SDK ),截至 2025 年 9 月官方說法是「已開始驅動我們幾乎所有主要的 agent loop」——deep research、影片製作、筆記,全跑在同一個 loop 引擎上。

所以這不是某個 KOL 自己造的詞要你跟風。是工具供應商、實作者、社群三邊各自從不同方向,撞到了同一個結論。


一段四年的演進史:從 ReAct 到 Ralph

Loop Engineering 不是憑空蹦出來的。它是 agentic 模式四年慢慢收斂的終點。我把時間線拉給你看:

agentic 模式演進時間線

2022.10  ReAct (Princeton/Google)   推理→行動→觀察→再推理
2023.03  AutoGPT                    給目標自我拆解,但無限迴圈+爆帳單
2023     Reflexion (NeurIPS)        加入自我反思層
2024-25  Plan-and-Execute           規劃與執行分離,可平行化
2025.07  Ralph Loop (Geoff Huntley) fresh context + 檔案系統當記憶
2026.05  原生 /goal (Claude Code)    evaluator model 驗證完成條件

幾個關鍵節點:

  • ReAct(2022.10) 是這一切的源頭。Princeton 和 Google 把「Reasoning + Acting」形式化:模型先推理、呼叫工具、讀結果、再推理,循環到完成。在 ALFWorld 任務上比純行動方案進步 34%。
  • AutoGPT(2023.3) 是第一次大爆紅的嘗試——給它一個高層目標,它自己拆子任務、上網、操作檔案。GitHub star 數週內衝到十萬,但它苦於無限迴圈和爆量 API 帳單,最後停在 demo 階段。這是第一個血淋淋的教訓:沒有 stop 條件的 loop,是會吃光你錢包的怪物。
  • Ralph Loop(2025.7) 是我最喜歡的一段。澳洲工程師 Geoffrey Huntley 想出一個土到掉渣卻有效的招:把 agent 塞進一個 while true 的 shell loop 裡,每一輪都重開一個全新的 context、從 disk 上的 prompt 檔重新讀任務。

Ralph 為什麼天才?因為它一刀解決了長對話的兩個老問題:context 會越長越爛(後面會講的 context rot),還有 agent 自以為做完就提早跑掉。每輪 fresh context = 不會腐化;用 stop hook 驗證真的完成條件 = 不會早退。它甚至不用對話歷史當記憶,它把檔案系統當記憶。乾,有夠簡單,但就是會動。

到了 2026.5,Claude Code 直接把這套做成原生的 /goal 指令——用一個獨立的 evaluator model 去檢查完成條件,跨多輪自主工作。OpenAI Codex 也在 2026 年 4–5 月間相繼推出對應功能。這代表 loop primitives 正在從「自己寫 bash script」變成「平台原生功能」。

Ralph 的精神用偽碼長這樣,你看完大概就懂了為什麼它叫「stupidly simple」:

# Ralph Loop 的本質:每輪 fresh context,狀態存在 disk
while true; do
  # 每次都是乾淨的 agent 實例,從 prompt 檔重讀任務
  claude-code --prompt-file ./PROMPT.md --no-conversation-history

  # stop hook 驗證真正的完成條件,不是讓 agent 自己說「我做完了」
  if ./verify-done.sh; then
    echo "所有 PRD 項目通過驗證,收工"
    break
  fi
  # 沒過?把當前狀態(含錯誤)留在 disk,下一輪重新開始
done

關鍵在 --no-conversation-history 和那個 verify-done.sh。記憶不在對話裡,在檔案系統;完成與否不靠 agent 自評,靠外部腳本。這兩點,等下你會發現是整個 Loop Engineering 的命脈。


一個 loop 怎麼組起來:五塊積木 + 記憶

光講概念太虛。實務上一個能跑的 loop,業界整理 出來大概是這五塊積木加一個記憶:

五塊模組化積木組裝成系統

  1. Automations(自動化心跳)——定時觸發、自動發掘並 triage 工作。它是整個 loop 的心跳,沒有它,loop 不會自己動起來。
  2. Worktrees(隔離)——用平行的 git worktree,讓多個 agent 同時動工而不會互相踩檔。多 agent 並行最怕的就是兩隻同時改同一個檔案,這塊就是防呆。
  3. Skills(技能)——把專案知識和慣例寫進 SKILL.md,免得每次 session 都要重新跟 AI 解釋「我們專案的 commit 格式是這樣」。
  4. Plugins / Connectors——透過 MCP 接上真實工具:issue tracker、資料庫、Slack。沒有這層,agent 就只是個會打字的腦,沒有手。
  5. Sub-agents(子代理)——把「產出」和「驗證」拆給不同 agent。原因很現實:寫 code 的那個模型,幫自己打分數時太佛心了,它會覺得自己寫的都對。

再加上第六塊,Memory(外部記憶)——一個 markdown、一塊 Linear 或 GitHub board,重點是它活在單次對話之外。因為模型每跑完一輪就忘光光,記憶必須放在 disk 上。

把這些組起來,一個真實的 loop 端到端大概是這樣跑的:

早上 automation 觸發 → 跑 triage skill 找出昨晚 CI 掛在哪、有哪些 issue → 寫進記憶檔 → 對每個可處理的項目開一個隔離 worktree、派一隻 sub-agent 草擬修復 → 另一隻 reviewer sub-agent 對照專案標準和測試做驗證 → connector 自動開 PR、更新 ticket → 搞不定的留在 inbox 等人類審。那個狀態檔記得「試過什麼、過了什麼、還開著什麼」,所以明天早上這一輪會接著今天停下的地方繼續。

你會發現,這已經不是「我在用 AI 寫 code」,而是「我在設計一條會自己上工的產線」。Addy 說這比「agent harness engineering」還高一層,我覺得很精準。


底層燃料:對抗 context rot 的 context engineering

這裡要岔開講一個容易被略過、但其實是命脈的東西。Loop 能長時間自己跑,靠的不是模型多神,而是底層的 context engineering。

Anthropic 官方 把它定義成「在 LLM 推理過程中,策展與維護最佳 token 集合的策略」,並點名兩個會殺死 loop 的失敗模式:

  • Context Rot(脈絡腐化):context window 越長,模型的召回和推理品質就越爛。這不是模型偷懶,是 transformer 架構本質——Anthropic 官方點名 token 兩兩之間 n² 關係隨規模膨脹;實務上更常見的表現是注意力分佈被稀釋、中段資訊大量流失(也就是 lost-in-the-middle 現象)。
  • Finite Attention Budget(有限注意力預算):「每塞一個新 token 進去,就消耗掉一點預算。」所以原則永遠是:找出最小的高訊號 token 集合,而不是把所有東西都倒進去。

對應的解法,剛好就是 loop 能長跑的基礎建設:

技法在做什麼
Compaction(壓縮)把對話歷史摘要、用壓縮後的 context 重啟,保留關鍵決策
Agentic Memory在 window 外寫持久筆記,需要時再撈回來(就是 Ralph 的精神)
Sub-agent 架構專責 agent 用乾淨 context 處理聚焦任務,只回傳 1,000–2,000 token 摘要
Just-in-Time 取用不預載全部資料,靠輕量識別碼動態載入,模仿人類「需要才去查」
Right Altitudesystem prompt 在「硬編碼到死板」與「空泛到沒用」之間取平衡

看出來了嗎?Ralph Loop 的「每輪 fresh context」其實就是 compaction 的暴力版;它的「檔案系統當記憶」就是 agentic memory 的土砲版。Loop Engineering 不是取代 context engineering,它是站在 context engineering 的肩膀上。 你底層 context 沒管好,上面的 loop 跑越久只會爛越快。


沒人看管的 loop,也是沒人看管在犯錯的 loop

講了這麼多好處,該潑冷水了。Loop Engineering 最反直覺的一點是:loop 設計得越好、越自主,它的失敗模式反而越尖銳、越難察覺。

失控自動化的風險警示概念圖

我把風險分四類整理:

風險類別具體會發生什麼
技術失敗context overflow、卡在無限幻覺迴圈(狂打 API、亂改 state)、錯誤層層累積
人因風險理解負債(code 出得比你能讀懂的快)、認知投降(不加判斷照單全收)
驗證落差一句話講完:「沒人看管的 loop,也是沒人看管在犯錯的 loop」
安全攻擊面agent 自行越權改權限/schema、被汙染資料挾持 loop 去外洩程式碼

安全這塊我覺得最值得嚴肅看。有資安研究者 直接指出,傳統靜態規則引擎根本跟不上「每小時數千次語意複雜的自主互動」。三個新攻擊面特別毛:

  • Agentic Overreach:agent 自己決定把某個身分權限放大、或重構整個資料庫 schema——它不是惡意,它只是「覺得這樣比較有效率」。
  • Infinite Hallucination Loop:agent 誤解邊界,卡在錯誤的遞迴裡狂搥 API。
  • Prompt Injection at Scale:惡意 payload 藏在不可信資料源裡,挾持整個 loop,叫它用工具權限把企業程式碼外洩出去。

然後是錢。根據業界估算(單一來源,量級參考用),單一 agent 大概吃掉一般 chat 約 4 倍的 token,multi-agent 系統更是直接拉到 15 倍。所以那種「同時開五隻 Claude 平行跑」的玩法,本質上是 token 富裕者的遊戲,不是人人玩得起。乾爆。


所以這到底是不是又一個 buzzword?

公道話要講。社群(Reddit r/AI_Agents 那群人)的質疑不是沒道理:很多號稱「agent」的東西,拆開看根本只是包裝過頭的 if-then loop,或是換皮的 RPA,「卡在一個沒有真正自主性的 hype 迴圈裡」。這種懷疑很健康,能逼大家別把 demo 當 production。

但我比較認同 一位日本 AI 開發者 的平衡立場:

「把所有工作都改成 loop 是過早的隨波逐流;但把它當『只是個 buzzword』而完全無視,也是浪費。」

我自己的判斷是:Loop Engineering 是真實的抽象上移,但它放大的是責任,不是讓你變輕鬆。 你不再當人肉保母去 prompt,但你變成那條產線的設計者和品管。理解負債和認知投降這兩個詞,會是接下來幾年工程師最該警惕的新型技術債。

如果你想開始,我的建議是別一步到位:

  • 先小後大:挑一個低風險、而且可以自動驗證的任務起跑第一個 loop——更新依賴套件、跑 CI triage、同步文件,這種掛了也不會死人的。
  • 記憶上 disk:用 markdown 狀態檔加 SKILL.md 固化專案知識,別依賴對話記憶。
  • 產出和驗證一定要分開:用獨立的 sub-agent 或 evaluator 做驗證,永遠不要讓寫 code 的模型自己幫自己打分數。
  • 護欄在啟動前就定好:iteration 上限、token 預算、no-progress 偵測、明確且機器可驗證的「done」條件——這些是 AutoGPT 用爆掉的帳單換來的教訓,別再踩一次。
  • 善用現成 primitives:Claude Code 的 /loop、/goal、.claude/agents/、git worktree 都是現成的,不用自己造輪子。

人類的角色正在從「寫 code」→「寫 prompt」→「設計 loop」→「打造那座跑 loop 的工廠」一路往上爬。Prompt engineering 不會消失,就像組合語言沒消失一樣——它只是不再是大多數人每天該花最多心力的那一層了。

下次你又想坐在那裡一句一句餵 AI 的時候,可以停下來問自己一句:這件事,我是不是該寫成一個 loop?


參考資料

本文基於我自己的一份深度研究報告整理而成。Loop Engineering 是 2025–2026 高速演進中的概念,多數來源為業界文章而非 peer-reviewed 論文,定義仍在流動;核心一手來源(Anthropic、Addy Osmani 等)同時是工具供應商,閱讀時請自帶一點懷疑。成本級距(4x / 15x token)為單一來源估計,僅供量級參考。

8GB 的 RK3588 能跑多聰明的 LLM?ROCK 5C 用 NPU 實測 5 個模型

先講結論,省得你滑到最後: 在一片 8GB 的 RK3588 板子上,用 NPU 跑得最聰明的是 Qwen3-4B-Instruct-2507,我出的 7 題全對,但每秒只吐 3.7 個 token。 想要順一點的對話體驗,Qwen3.5-2B 的 8.4 tok/s 是比...